អ្វីខ្លះខូច ពេលខ្ញុំធ្វើគេហទំព័រជាភាសាខ្មែរ
នៅក្នុងអត្ថបទនេះ
គេហទំព័រនេះមានបីភាសា៖ អង់គ្លេស ខ្មែរ និងអេស្ប៉ាញ ដែលជាភាសាទាំងបីដែលខ្ញុំនិយាយ។
ភាសាអង់គ្លេស និងអេស្ប៉ាញដំណើរការល្អជាមួយឧបករណ៍គ្រប់យ៉ាងដែលខ្ញុំបានសាកល្បង។ ភាសាខ្មែរធ្វើឱ្យមានអ្វីមួយខូចស្ទើរតែគ្រប់ជំហាន៖ រយៈពេលអាន ពុម្ពអក្សរ រូបភាពមើលជាមុននៃតំណ និង PDF ប្រវត្តិរូប។ ខ្ញុំបង្កើតគេហទំព័រនេះ ដូចដែលខ្ញុំបង្កើតអ្វីៗភាគច្រើននាពេលឥឡូវ គឺភ្នាក់ងារ AI សរសេរកូដភាគច្រើន ហើយខ្ញុំជាអ្នកពិនិត្យ។ ភ្នាក់ងារនោះក៏ជួបជញ្ជាំងទាំងអស់នេះដែរ។
នេះជារឿងនីមួយៗដែលខូច មូលហេតុ និងរបៀបដែលខ្ញុំជួសជុលវា។ បើអ្នកកំពុងបង្កើតអ្វីមួយជាភាសាខ្មែរ រឿងភាគច្រើនខាងក្រោមនឹងទាក់ទងនឹងអ្នកដែរ។
ក្រឡេកមើលអក្សរខ្មែរបន្តិច
អ្នកអានខ្មែរដឹងរឿងទាំងនេះស្រាប់ហើយ ប៉ុន្តែកម្មវិធីកុំព្យូទ័រភាគច្រើនមិនដឹងទេ។ លក្ខណៈបីយ៉ាងនៃរបៀបសរសេរខ្មែរ បង្កបញ្ហាស្ទើរតែទាំងអស់៖
- គ្មានដកឃ្លារវាងពាក្យ។ ភាសាខ្មែរដកឃ្លាតែរវាងឃ្លា ប្រហែលនៅកន្លែងដែលភាសាអង់គ្លេសដាក់សញ្ញាក្បៀស។
- អក្សរជាន់គ្នា។ ព្យញ្ជនៈមួយអាចនៅពីក្រោមព្យញ្ជនៈមួយទៀត ហើយស្រៈអាចនៅពីលើ ពីក្រោម ពីមុខ ឬពីក្រោយព្យញ្ជនៈរបស់វា។
- អក្សរខ្លះត្រូវវាយក្រោយ អក្សរដែលវាត្រូវគូរនៅពីមុខ។
រឿងទីបីងាយមើលជាងគេ។ វាយពាក្យនេះម្ដងមួយគ្រាប់ចុច ហើយមើលគ្រាប់ចុចទីបី៖
កម្មវិធីភាគច្រើនចាត់ទុកអត្ថបទជាជួរអក្សរ មួយបន្ទាប់ពីមួយ។ អក្សរខ្មែរបំបែកគំនិតនោះទាំងបីយ៉ាង។
រយៈពេលអាន៖ ភាសាខ្មែរមិនដកឃ្លារវាងពាក្យ
អត្ថបទនីមួយៗបង្ហាញថា ត្រូវចំណាយពេលអានប៉ុន្មាន។ ដើម្បីគណនាវា គេរាប់ពាក្យ រួចចែកនឹងប្រហែល ២២០ ពាក្យក្នុងមួយនាទី។ វិធីធម្មតាដើម្បីរាប់ពាក្យ គឺបំបែកអត្ថបទនៅគ្រប់កន្លែងដែលមានដកឃ្លា។ ក្នុងភាសាខ្មែរ វិធីនោះរកឃើញឃ្លា មិនមែនពាក្យទេ។ សាកល្បងវាលើប្រយោគដំបូងនៃអត្ថបទអំពីការពិនិត្យ pull request របស់ខ្ញុំ៖
ការបំបែកតាមដកឃ្លារកឃើញ ៤ ពាក្យ។ JavaScript មានឧបករណ៍មួយដែលដឹងថាពាក្យខ្មែរចាប់ផ្ដើម និងបញ្ចប់នៅត្រង់ណា ឈ្មោះ Intl.Segmenter ហើយវារកឃើញ ១៣ ពាក្យ។ នេះជាវិធីទាំងពីរជាកូដ៖
const text = 'ខ្ញុំលែងអានកូដគ្រប់បន្ទាត់ មុនពេលវាត្រូវបាន merge ទៀតហើយ។';

text.split(' ').length; // 4

const words = new Intl.Segmenter('km', { granularity: 'word' }).segment(text);
[...words].filter((w) => w.isWordLike).length; // 13
លើអត្ថបទទាំងមូល ភាពខុសគ្នានេះកាន់តែធំ។ បើរាប់តាមដកឃ្លា អត្ថបទ «តេស្តជាប់ តែកម្មវិធីខូច» របស់ខ្ញុំជាភាសាខ្មែរ នឹងប្រាប់ថាអាន ៣ នាទី ខណៈដែលភាសាអង់គ្លេសប្រាប់ថា ៩ នាទី។ បើរាប់ជាពាក្យ វាគឺ ១១ នាទី។
Intl.Segmenter មានស្រាប់នៅក្នុង browser, Node និង Bun។ វារកពាក្យខ្មែរដោយប្រើបញ្ជីពាក្យ ដូច្នេះវាជាការស្មានដែលល្អណាស់ ប៉ុន្តែមិនល្អឥតខ្ចោះទេ ហើយនោះគ្រប់គ្រាន់សម្រាប់រយៈពេលអាន។ គេហទំព័ររាប់តែម្ដង នៅពេលវា build ទំព័រ៖
function countWords(text: string, lang: Lang): number {
  let n = 0;
  for (const part of new Intl.Segmenter(lang, { granularity: 'word' }).segment(
    text,
  )) {
    if (part.isWordLike) n++;
  }
  return n;
}
isWordLike ទុកដកឃ្លា និងវណ្ណយុត្តិចោល ដូច្នេះមានតែពាក្យប៉ុណ្ណោះដែលត្រូវបានរាប់។ ភាសាអង់គ្លេស និងអេស្ប៉ាញឆ្លងកាត់កូដដដែលនេះ ហើយទទួលបានលទ្ធផលដូចមុន។
ពុម្ពអក្សរ និងកម្ពស់បន្ទាត់
គេហទំព័រនេះប្រើ Google Sans សម្រាប់ទាំងអក្សរឡាតាំង និងអក្សរខ្មែរ។ វាមកជាពីរឯកសារ មួយមានអក្សរឡាតាំង និងមួយទៀតមានអក្សរខ្មែរ ហើយឯកសារនីមួយៗប្រាប់ថាវាមានអក្សរណាខ្លះ។ ការបង្ហាញអក្សរលើអេក្រង់ជាផ្នែកងាយស្រួល។ ការទុកកន្លែងឱ្យវាគ្រប់គ្រាន់ ចំណាយពេលយូរជាង។
អក្សរខ្មែរនៅក្នុងកូដ
សូម្បីតែអត្ថបទនេះក៏ខូចដែរ ពេលខ្ញុំកំពុងសរសេរវា។ ប្លុកកូដប្រើពុម្ពអក្សរផ្សេង គឺ Google Sans Code ហើយវាគ្មានអក្សរខ្មែរសោះ។ ពេលពុម្ពអក្សរមួយខ្វះអក្សរណាមួយ browser ខ្ចីអក្សរនោះពីពុម្ពអក្សរផ្សេងទៀតនៅលើកុំព្យូទ័ររបស់អ្នក។
ទូរស័ព្ទ និងកុំព្យូទ័រយួរដៃភាគច្រើនមានពុម្ពអក្សរខ្មែរសម្រាប់ខ្ចី ដូច្នេះវាប្រើបាន ប៉ុន្តែមើលទៅមិនដូចផ្នែកផ្សេងទៀតនៃទំព័រ។ កុំព្យូទ័រដែលថតរូបអេក្រង់ឱ្យខ្ញុំគ្មានទេ ដូច្នេះវាខ្ចីពី Unifont ដែលគូរអក្សរខ្មែរម្ដងមួយតួៗ ដោយមិនដាក់ជាន់គ្នា ឬរំកិលអក្សរណាមួយសោះ៖
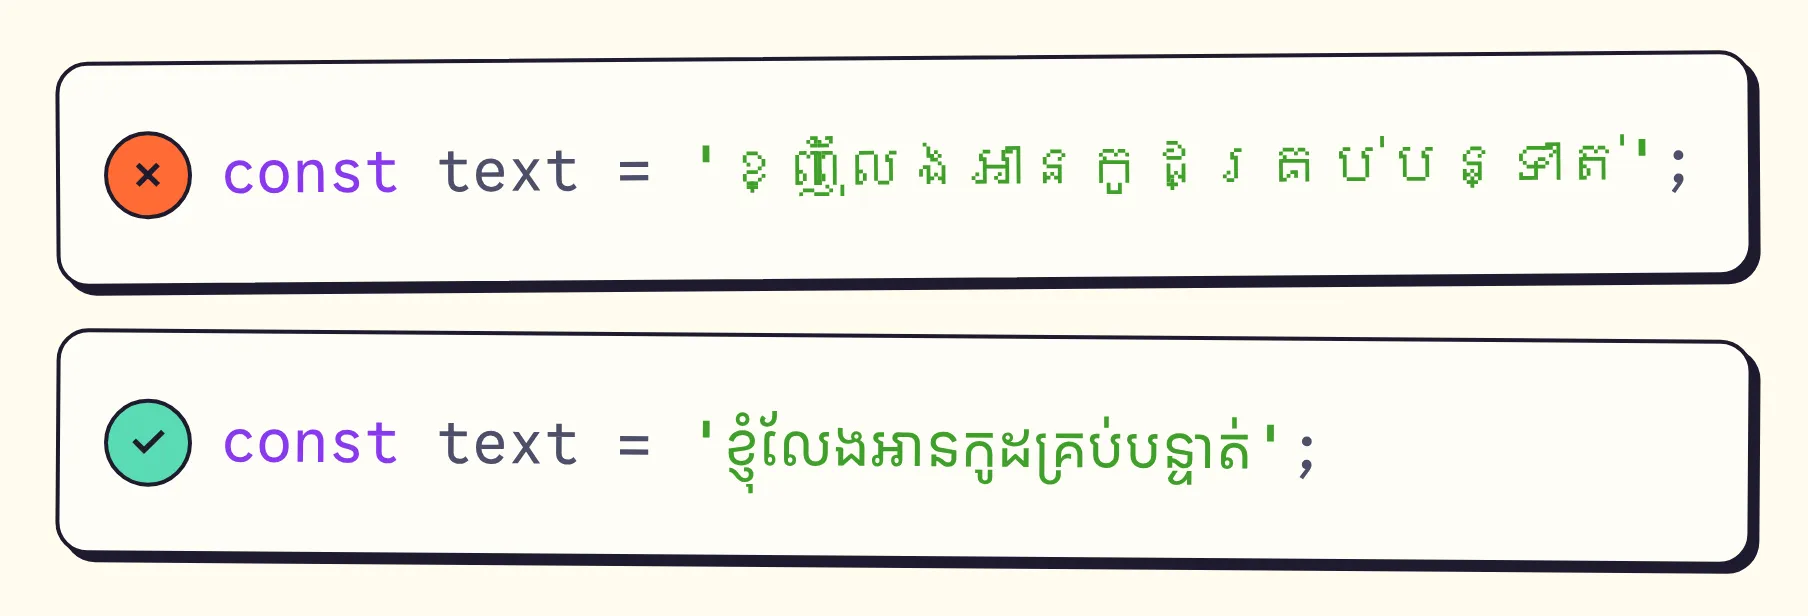
ខាងលើ៖ អក្សរខ្មែរខ្ចីពី Unifont។ ខាងក្រោម៖ ពុម្ពអក្សរខ្មែររបស់គេហទំព័រផ្ទាល់។
ដំណោះស្រាយ គឺផ្ដល់ឯកសារទីពីរដល់ពុម្ពអក្សរកូដ ដែលជាឯកសារខ្មែរដដែល ដែលផ្នែកផ្សេងទៀតនៃទំព័រប្រើស្រាប់។ ក្នុងការកំណត់ពុម្ពអក្សររបស់គេហទំព័រ ពុម្ពអក្សរកូដឥឡូវមានឯកសារពីរ ហើយឯកសារទីពីរសម្រាប់តែអក្សរខ្មែរប៉ុណ្ណោះ៖
{
  name: 'Google Sans Code',
  // ...
  options: {
    variants: [
      {
        src: ['./src/assets/fonts/google-sans-code-latin.woff2'],
        unicodeRange: latinRange,
      },
      // Google Sans Code has no Khmer, so Khmer in code uses the same Khmer
      // file as the rest of the site.
      {
        src: ['./src/assets/fonts/google-sans-khmer.woff2'],
        unicodeRange: khmerRange,
      },
    ],
  },
},
unicodeRange គឺជាបញ្ជីអក្សរដែលឯកសារនីមួយៗមាន។ Browser មានឯកសារខ្មែរនោះរួចហើយ សម្រាប់ផ្នែកផ្សេងទៀតនៃទំព័រ ដូច្នេះវាមិនទាញយកម្ដងទៀតទេ។
បន្ទាត់ខ្ពស់ជាងមុន
អក្សរខ្មែរជាន់គ្នាពីលើ និងពីក្រោមបន្ទាត់ ដូច្នេះវាត្រូវការចន្លោះរវាងបន្ទាត់ច្រើនជាងភាសាអង់គ្លេស។ បើចន្លោះតិចពេក ផ្នែកខាងក្រោមនៃបន្ទាត់មួយ នឹងប៉ះផ្នែកខាងលើនៃបន្ទាត់បន្ទាប់៖
ហើយផឹកទឹកក្រូចឆ្មារ
ហើយផឹកទឹកក្រូចឆ្មារ
ដូច្នេះអក្សរខ្មែរទទួលបានកម្ពស់បន្ទាត់ ១,៨៖
[lang='km'] {
  line-height: 1.8;
}

/* Khmer headings in an article take two notebook rules a line. */
.prose :where(h2:lang(km)) {
  line-height: calc(var(--rule-gap) * 2);
}
ច្បាប់ទីពីរ គឺសម្រាប់ក្រដាសសៀវភៅនៅពីក្រោយអត្ថបទនេះ។ បន្ទាត់អក្សរនីមួយៗនៅលើបន្ទាត់សៀវភៅមួយ ហើយបន្ទាត់សៀវភៅឃ្លាតពីគ្នា ៣២ ភីកសែល។ ចំណងជើងភាសាអង់គ្លេសប្រើបន្ទាត់មួយ។ ចំណងជើងខ្មែរ ដូចចំណងជើងខាងលើ ត្រូវការពីរ។
គ្មានអក្សរទ្រេតក្លែងក្លាយ
Google Sans គ្មានអក្សរខ្មែរទ្រេតទេ។ ពេលទំព័រមួយស្នើសុំអក្សរទ្រេត browser ផ្អៀងអក្សរឈរ ហើយអក្សរដែលជាន់គ្នា មើលទៅមិនល្អទេពេលផ្អៀង៖
ដូច្នេះជាភាសាខ្មែរ អក្សរពន្យល់ក្រោមរូបភាពនៅតែឈរត្រង់ ដោយប្រើទឹកខ្មៅស្រាលជាង ហើយការសង្កត់ធ្ងន់នៅក្នុងប្រយោគប្រើអក្សរដិត។
រូបភាពមើលជាមុន៖ គូរអក្សរខ្មែរដោយគ្មាន browser
ពេលនរណាម្នាក់ចែករំលែកទំព័រមួយនៅលើ LinkedIn, Telegram ឬ WhatsApp កម្មវិធីនោះបង្ហាញរូបភាពមើលជាមុន។ គេហទំព័រនេះគូររូបភាពមួយសម្រាប់ទំព័រនីមួយៗ ជាភាសានីមួយៗ នៅពេល build។
អ្វីដែលខុស
ចាំពាក្យដែលអ្នកបានវាយនៅខាងលើទេ? គ្រាប់ចុចទីបីត្រូវគូរមុនគេ នៅខាងឆ្វេង។ ការគណនារឿងបែបនេះ ដូចជាអក្សរណាជាន់គ្នា និងផ្នែកនីមួយៗនៅត្រង់ណា ហៅថា shaping។ Browser ធ្វើ shaping ឱ្យអ្នក។ នៅពេល build គ្មាន browser ទេ ហើយកំណែដំបូងទុកឱ្យ resvg ដែលជាបណ្ណាល័យបំប្លែងរូបភាព SVG ទៅជា PNG រៀបចំអក្សរ។ វាមិនធ្វើ shaping អក្សរខ្មែរទេ៖
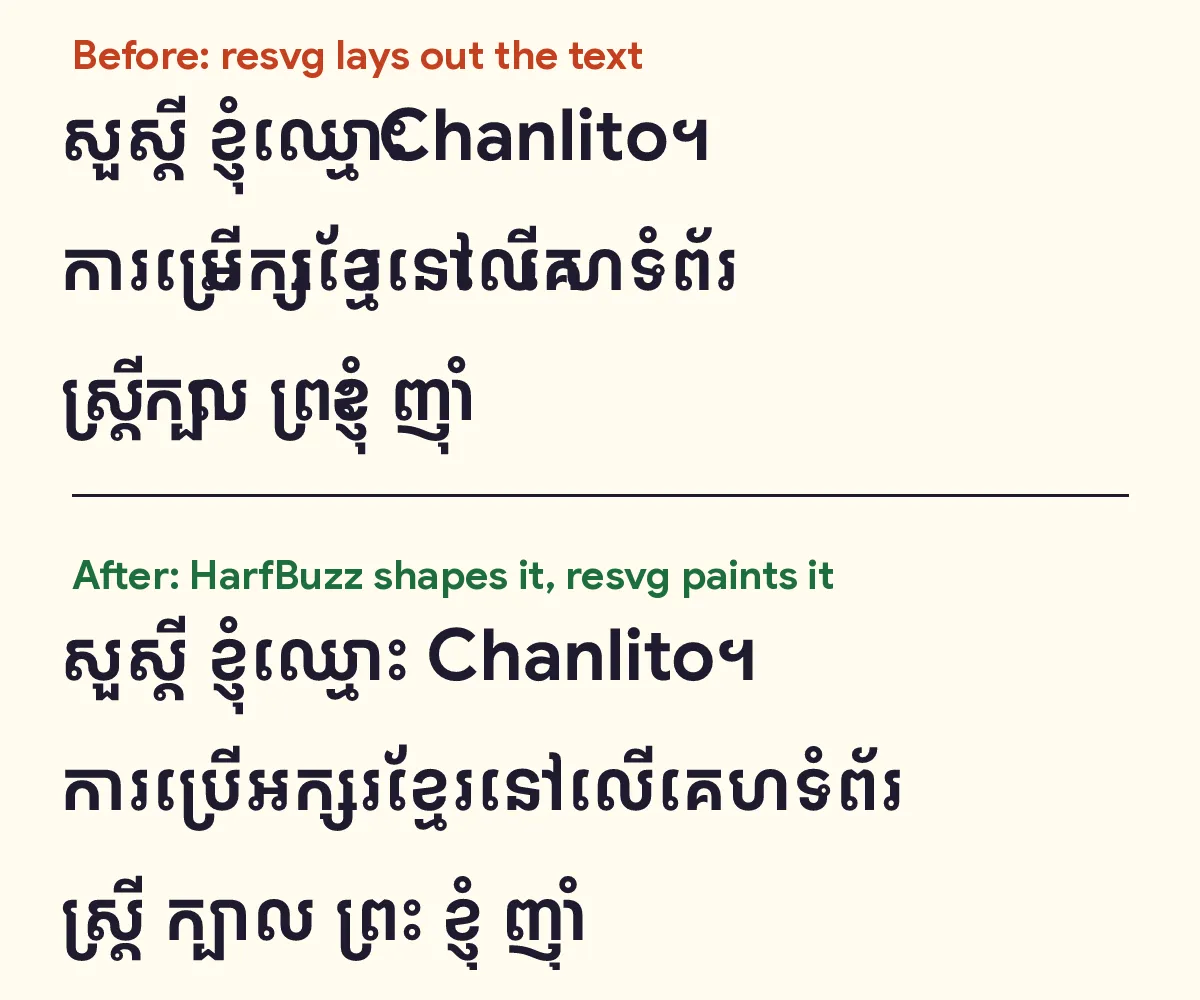
អត្ថបទដដែល ពុម្ពអក្សរដដែល។ ភាពខុសគ្នាគឺនៅត្រង់អ្នកណាជាអ្នកធ្វើ shaping។
អក្សរខ្លះបាត់ អក្សរដែលជាន់គ្នានៅខុសកន្លែង ហើយពាក្យ ឈ្មោះ បុកចូល Chanlito តែម្ដង។
Shaping សិន ទើបគូរ
Browser ធ្វើ shaping ដោយប្រើបណ្ណាល័យមួយឈ្មោះ HarfBuzz។ Chrome, Firefox និង Android សុទ្ធតែប្រើវា។ ដូច្នេះឥឡូវគេហទំព័រនេះក៏ប្រើវាដែរ។ HarfBuzz គណនារាង និងទីតាំងនៃអក្សរនីមួយៗ រាងនីមួយៗក្លាយជាគ្រោង ហើយ resvg គ្រាន់តែលាបពណ៌គ្រោងទាំងនោះ។ វាមិនចាំបាច់យល់អក្សរណាមួយទេ៖
function shape(text: string, size: number): Shaped {
  const scale = size / face.upem;
  const glyphs: { path: string; x: number; y: number }[] = [];
  let pen = 0;
  for (const run of runs(text)) {
    const buffer = new hb.Buffer();
    buffer.addText(run.text);
    buffer.guessSegmentProperties();
    if (run.khmer) {
      buffer.setScript('Khmr');
      buffer.setLanguage('km');
    }
    hb.shape(font, buffer);
    for (const g of buffer.getGlyphInfosAndPositions()) {
      const path = font.glyphToPath(g.codepoint);
      if (path) {
        glyphs.push({
          path,
          x: (pen + (g.xOffset ?? 0)) * scale,
          y: -(g.yOffset ?? 0) * scale,
        });
      }
      pen += g.xAdvance ?? 0;
    }
  }
  // ...
}
បន្ទាត់ដែលបន្លិច គឺផ្នែកសំខាន់៖ ប្រាប់ HarfBuzz ថាអត្ថបទនេះជាភាសាខ្មែរ ធ្វើ shaping រួចប្ដូររាងអក្សរនីមួយៗទៅជាគ្រោង។ ចំណងជើងដូចជា «ខ្ញុំឈ្មោះ Chanlito» ត្រូវបំបែកជាមុន ដូច្នេះផ្នែកខ្មែរប្រើច្បាប់ខ្មែរ ហើយ «Chanlito» ប្រើច្បាប់ឡាតាំង។ ឥឡូវរូបភាពចេញមកដូចដែល Chrome គូរ ហើយមានទំហំប្រហែល ៣៥ KB នីមួយៗ តូចល្មមសម្រាប់ WhatsApp។
PDF ប្រវត្តិរូប៖ អត្ថបទដែលចម្លងចេញមកត្រឹមត្រូវ
គេហទំព័រនេះក៏បង្កើតប្រវត្តិរូបរបស់ខ្ញុំជា PDF ជាភាសានីមួយៗដែរ។ PDF ត្រូវតែមើលទៅត្រឹមត្រូវ ហើយអត្ថបទរបស់វាត្រូវតែចេញមកត្រឹមត្រូវ នៅពេលនរណាម្នាក់ចម្លង ឬស្វែងរកវា។ ឧបករណ៍ជ្រើសរើសបុគ្គលិកអានអត្ថបទនោះ មិនមែនអានរូបភាពទេ។
ខ្ញុំបានសាកល្បងឧបករណ៍បី។ Print to PDF របស់ Chrome គូរអក្សរខ្មែរបានត្រឹមត្រូវ ប៉ុន្តែគេហទំព័រ build នៅលើ Cloudflare ដែលគ្មាន Chrome សម្រាប់ print ទេ។ pdfkit ដែលជាបណ្ណាល័យ JavaScript ពេញនិយម ក៏គូរវាបានត្រឹមត្រូវដែរ ប៉ុន្តែវារក្សាទុកអក្សរតាមលំដាប់ដែលវាត្រូវគូរ ជំនួសឱ្យលំដាប់ដែលវាត្រូវវាយ។ ដូច្នេះបើចម្លងពាក្យ ប្រព័ន្ធ ចេញពី PDF ជើង រ នឹងចេញមកមុនគេ៖
Typst ដែលជាឧបករណ៍រៀបចំអត្ថបទ (typesetting) ធ្វើ shaping ដោយប្រើកំណែមួយរបស់ HarfBuzz ហើយរក្សាទុកអក្សរតាមលំដាប់ដែលវាត្រូវបានវាយ ដូច្នេះទាំងការចម្លង និងការស្វែងរកដំណើរការ។ PDF នីមួយៗចំណាយពេល ៣០ ដល់ ៩០ មិល្លីវិនាទីដើម្បី build។ នេះជាផ្នែកនៃគំរូប្រវត្តិរូប ដែលរៀបចំសម្រាប់អក្សរខ្មែរ៖
// Khmer stacks marks above and below its letters, so it needs taller lines
// (as on the site) and a slightly smaller size to stay on one page.
#let pick(latin, khmer) = if km { khmer } else { latin }

#set text(
  font: ("Resume Sans Latin", "Resume Sans Khmer"),
  size: pick(9.4pt, 8.7pt),
  lang: data.lang,
)
#set par(leading: pick(0.62em, 0.86em))
pick ជ្រើសរើសតម្លៃឡាតាំង ឬតម្លៃខ្មែរ ដូច្នេះអក្សរខ្មែរទទួលបានទំហំតូចជាងបន្តិច និងបន្ទាត់ខ្ពស់ជាង ហើយប្រវត្តិរូបនៅតែសមនឹងមួយទំព័រ។
អ្វីដែលខ្ញុំចង់ប្រាប់អ្នកបង្កើតកម្មវិធីជាភាសាខ្មែរ
ការជួសជុលភាគច្រើនគឺតូចៗ។ ការរកឱ្យឃើញវាជាផ្នែកពិបាក ហើយអ្នកនឹងរកឃើញវា លុះត្រាតែអ្នកមើលអក្សរខ្មែរពិតៗ លើអេក្រង់ពិតៗ។ អ្វីដែលខ្ញុំនឹងធ្វើតាំងពីថ្ងៃដំបូង៖
- សាកល្បងជាមួយពាក្យពិបាក មិនមែនតែ សួស្តី ទេ។ ប្រើពាក្យដែលមានអក្សរជាន់គ្នា និងប្ដូរលំដាប់ ដូចជា ស្ត្រី ប្រព័ន្ធ និង ញ៉ាំ។
- រាប់ពាក្យដោយប្រើ
Intl.Segmenterកុំបំបែកតាមដកឃ្លា។ - ផ្ដល់បន្ទាត់ខ្ពស់ជាងអក្សរឡាតាំងដល់អក្សរខ្មែរ ហើយពិនិត្យចំណងជើងលើទូរស័ព្ទ ដែលវាចុះបន្ទាត់។
- នៅគ្រប់កន្លែងដែល browser មិនមែនជាអ្នកគូរអក្សររបស់អ្នក ដូចជារូបភាព និង PDF ត្រូវប្រាកដថា HarfBuzz ឬអ្វីមួយដែលសាងសង់លើវា ជាអ្នកធ្វើ shaping។
- ចម្លងអត្ថបទចេញពីអ្វីៗដែលអ្នកបង្កើត ហើយប្រៀបធៀបវាជាមួយអ្វីដែលអ្នកបានដាក់ចូល។
ភាសាថៃ ឡាវ និងភូមាក៏មិនដកឃ្លារវាងពាក្យដែរ ដូច្នេះរឿងជាច្រើនខាងលើក៏ទាក់ទងនឹងភាសាទាំងនោះដែរ។ បើអ្នកបង្កើតកម្មវិធីជាភាសាមួយក្នុងចំណោមភាសាទាំងនេះ តើអ្វីខ្លះបានខូចសម្រាប់អ្នក?
0ចូលចិត្ត
អរគុណ!