Lo que se rompió cuando puse mi sitio web en jemer
En esta página
Este sitio está en inglés, jemer y español, los tres idiomas que hablo.
El inglés y el español funcionaron con todas las herramientas que probé. El jemer rompió algo en casi cada paso: el tiempo de lectura, las fuentes, las imágenes de vista previa de los enlaces y el PDF del currículum. Construí el sitio como construyo casi todo ahora: un agente de IA escribe la mayor parte del código y yo lo reviso. El agente también chocó con cada uno de estos muros.
Aquí está cada cosa que se rompió, por qué y cómo la arreglé. No necesitas leer jemer para seguirlo. Si estás construyendo algo en jemer, casi todo esto te va a servir.
Un vistazo rápido al jemer
Tres rasgos de cómo se escribe el jemer causan casi todos los problemas:
- No hay espacios entre palabras. El jemer solo pone un espacio entre frases, más o menos donde el español pondría una coma.
- Las letras se apilan. Una consonante puede ir debajo de otra, y las vocales pueden ir arriba, abajo, antes o después de su consonante.
- Algunas letras se escriben después de la letra delante de la que se dibujan.
La tercera es la más fácil de ver. Escribe esta palabra tecla por tecla y fíjate en la tercera:
Casi todo el software trata el texto como una fila de letras, una tras otra. El jemer rompe esa idea de las tres maneras.
Tiempo de lectura: el jemer no tiene espacios
Cada artículo muestra cuánto se tarda en leerlo. Para calcularlo, cuentas las palabras y divides entre unas 220 por minuto. La forma habitual de contar palabras es partir el texto en cada espacio. En jemer eso encuentra frases, no palabras. Pruébalo con la primera frase de la versión en jemer de mi artículo sobre la revisión de pull requests:
Partiendo por los espacios salen 4 palabras. JavaScript tiene una herramienta que sabe dónde empiezan y terminan las palabras en jemer, Intl.Segmenter, y encuentra 13. Aquí están las dos en código:
const text = 'ខ្ញុំលែងអានកូដគ្រប់បន្ទាត់ មុនពេលវាត្រូវបាន merge ទៀតហើយ។';

text.split(' ').length; // 4

const words = new Intl.Segmenter('km', { granularity: 'word' }).segment(text);
[...words].filter((w) => w.isWordLike).length; // 13
En un artículo entero la diferencia crece. Contando espacios, mi artículo «Tests en verde, app rota» diría 3 minutos en jemer y 9 en inglés. Contando palabras, son 11.
Intl.Segmenter viene incluido en los navegadores, en Node y en Bun. Encuentra las palabras en jemer con una lista de palabras, así que es una muy buena aproximación, no una perfecta, y para un tiempo de lectura sobra. El sitio cuenta una sola vez, cuando genera las páginas:
function countWords(text: string, lang: Lang): number {
  let n = 0;
  for (const part of new Intl.Segmenter(lang, { granularity: 'word' }).segment(
    text,
  )) {
    if (part.isWordLike) n++;
  }
  return n;
}
isWordLike deja fuera los espacios y la puntuación, así que solo cuentan las palabras. El inglés y el español pasan por el mismo código y dan lo mismo que antes.
Fuentes y altura de línea
El sitio usa Google Sans tanto para las letras latinas como para las jemeres. Viene en dos archivos, uno con las letras latinas y otro con las jemeres, y cada archivo dice qué letras tiene. Poner las letras en pantalla fue lo fácil. Hacerles espacio llevó más tiempo.
Jemer dentro del código
Hasta este artículo se rompió mientras lo escribía. Los bloques de código usan otra fuente, Google Sans Code, y no tiene ninguna letra jemer. Cuando a una fuente le falta una letra, el navegador la toma prestada de otra fuente de tu computadora.
Casi todos los teléfonos y laptops tienen una fuente jemer a la que pedírsela, así que funciona, pero no combina con el resto de la página. La computadora que sacó mis capturas no tenía ninguna, así que la tomó de Unifont, que dibuja cada letra jemer por separado, sin apilar ni mover ninguna:
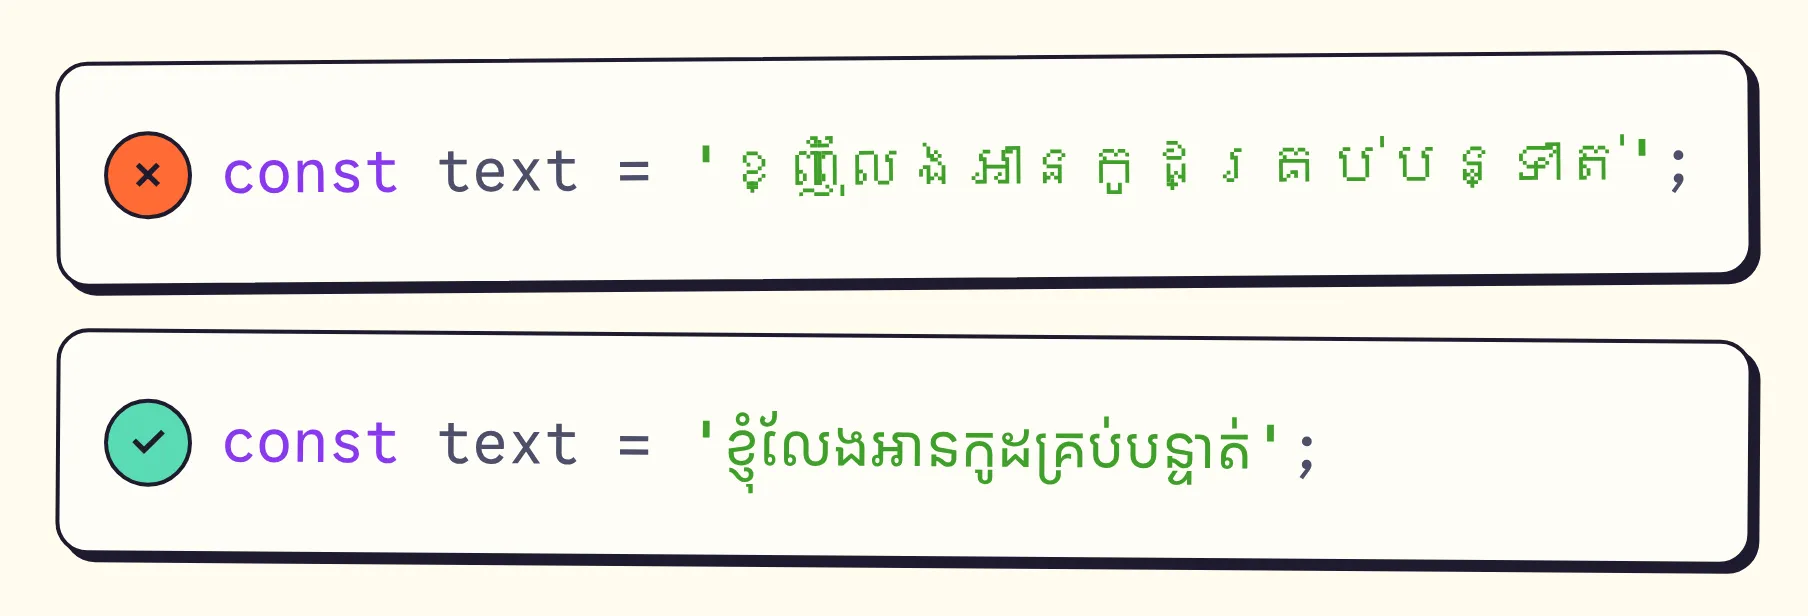
Arriba: jemer prestado de Unifont. Abajo: la fuente jemer del propio sitio.
El arreglo fue darle a la fuente del código un segundo archivo: el mismo archivo jemer que ya usa el resto de la página. En la configuración de fuentes del sitio, la fuente del código ahora tiene dos archivos, y el segundo es solo para las letras jemeres:
{
  name: 'Google Sans Code',
  // ...
  options: {
    variants: [
      {
        src: ['./src/assets/fonts/google-sans-code-latin.woff2'],
        unicodeRange: latinRange,
      },
      // Google Sans Code has no Khmer, so Khmer in code uses the same Khmer
      // file as the rest of the site.
      {
        src: ['./src/assets/fonts/google-sans-khmer.woff2'],
        unicodeRange: khmerRange,
      },
    ],
  },
},
unicodeRange es la lista de letras que cubre cada archivo. El navegador ya tiene el archivo jemer para el resto de la página, así que no lo vuelve a descargar.
Líneas más altas
El jemer apila letras por encima y por debajo de la línea, así que necesita más espacio entre líneas que el inglés. Con muy poco, la parte de abajo de una línea choca con la parte de arriba de la siguiente:
ហើយផឹកទឹកក្រូចឆ្មារ
ហើយផឹកទឹកក្រូចឆ្មារ
Así que el texto en jemer recibe una altura de línea de 1,8:
[lang='km'] {
  line-height: 1.8;
}

/* Khmer headings in an article take two notebook rules a line. */
.prose :where(h2:lang(km)) {
  line-height: calc(var(--rule-gap) * 2);
}
La segunda regla es para el papel de cuaderno detrás de este texto. Cada línea de texto va sobre una de sus rayas, y las rayas están a 32 píxeles una de otra. Un título en inglés cabe en una raya. Uno en jemer necesita dos.
Sin cursivas falsas
Google Sans no tiene letras jemeres inclinadas. Cuando una página pide cursiva de todos modos, el navegador inclina las rectas, y las letras apiladas no se ven bien inclinadas:
Por eso, en jemer, los pies de foto se quedan rectos con una tinta más clara, y el énfasis dentro de una frase va en negrita.
Vistas previas de enlaces: dibujar jemer sin navegador
Cuando alguien comparte una página en LinkedIn, Telegram o WhatsApp, la app muestra una imagen de vista previa. El sitio dibuja una para cada página en cada idioma cuando se genera.
Qué salió mal
¿Te acuerdas de la palabra que escribiste arriba? La tercera tecla se dibujó primero, a la izquierda. Calcular cosas así, qué letras se apilan y dónde va cada pieza, se llama shaping. Un navegador hace el shaping por ti. Cuando el sitio se genera no hay navegador, y la primera versión le dejaba el texto a resvg, una biblioteca que convierte una imagen SVG en PNG. No hace el shaping del jemer:
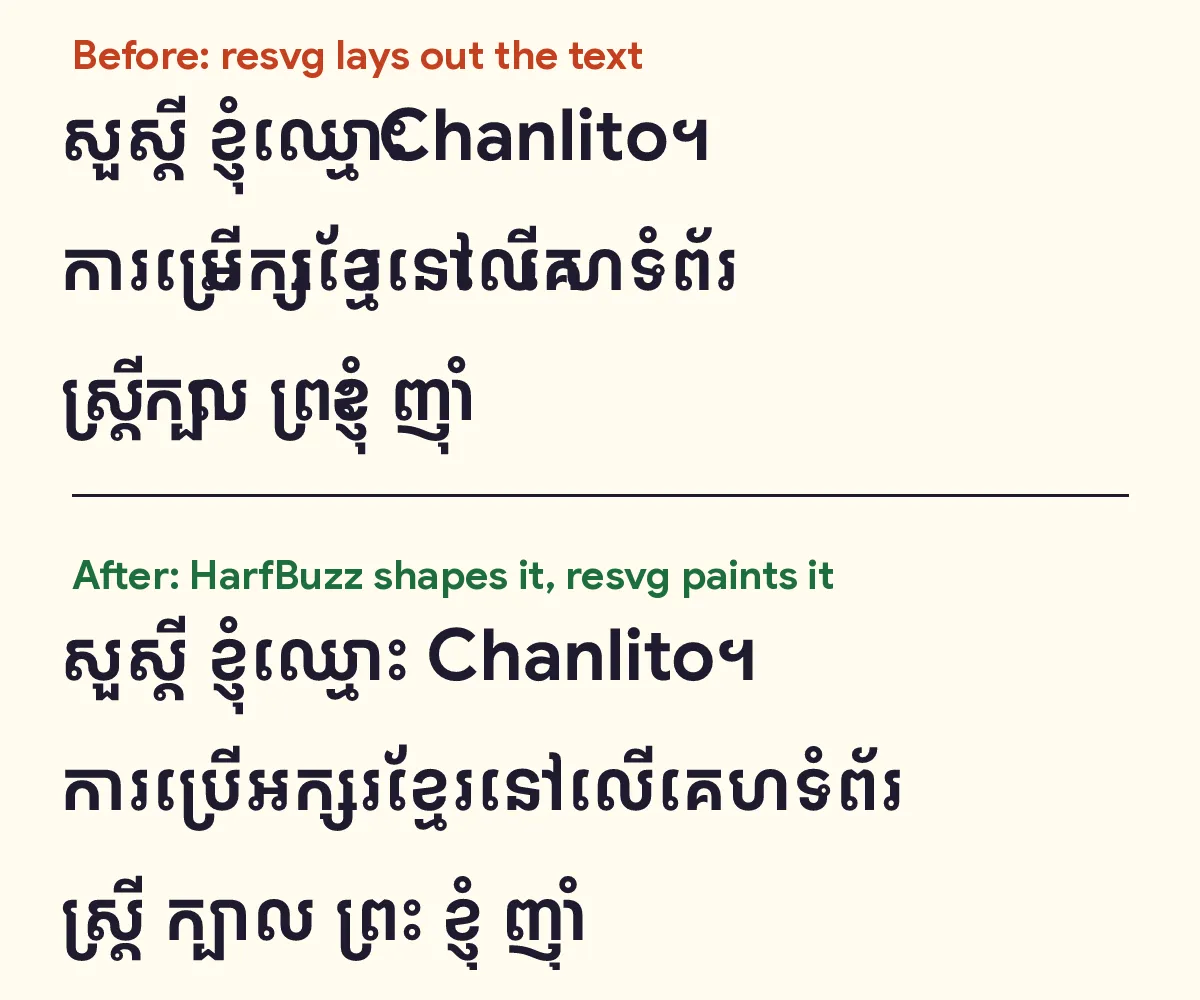
Mismo texto, misma fuente. La diferencia está en quién hace el shaping.
Faltaban letras, las letras apiladas quedaron en lugares equivocados, y ឈ្មោះ («nombre») se estrelló contra Chanlito.
Primero el shaping, después la pintura
Los navegadores hacen el shaping con una biblioteca llamada HarfBuzz. Chrome, Firefox y Android la usan. Así que ahora el sitio también. HarfBuzz calcula la forma y el lugar de cada letra, cada forma se convierte en un contorno, y resvg solo pinta los contornos. Nunca tiene que entender una letra:
function shape(text: string, size: number): Shaped {
  const scale = size / face.upem;
  const glyphs: { path: string; x: number; y: number }[] = [];
  let pen = 0;
  for (const run of runs(text)) {
    const buffer = new hb.Buffer();
    buffer.addText(run.text);
    buffer.guessSegmentProperties();
    if (run.khmer) {
      buffer.setScript('Khmr');
      buffer.setLanguage('km');
    }
    hb.shape(font, buffer);
    for (const g of buffer.getGlyphInfosAndPositions()) {
      const path = font.glyphToPath(g.codepoint);
      if (path) {
        glyphs.push({
          path,
          x: (pen + (g.xOffset ?? 0)) * scale,
          y: -(g.yOffset ?? 0) * scale,
        });
      }
      pen += g.xAdvance ?? 0;
    }
  }
  // ...
}
Las líneas resaltadas son lo importante: decirle a HarfBuzz que el texto está en jemer, hacer el shaping y convertir la forma de cada letra en un contorno. Un título como «ខ្ញុំឈ្មោះ Chanlito» se divide primero, así que el jemer recibe las reglas del jemer y «Chanlito» las del alfabeto latino. Ahora las imágenes salen como las dibujaría Chrome, de unos 35 KB cada una, lo bastante pequeñas para WhatsApp.
El PDF del currículum: texto que se copia bien
El sitio también genera mi currículum en PDF en cada idioma. Un PDF tiene que verse bien, y su texto tiene que salir bien cuando alguien lo copia o lo busca. Las herramientas de selección de personal leen ese texto, no la imagen.
Probé tres herramientas. Imprimir a PDF desde Chrome dibujaba bien el jemer, pero el sitio se genera en Cloudflare, donde no hay un Chrome con el que imprimir. pdfkit, una biblioteca de JavaScript muy usada, también lo dibujaba bien, pero guardaba las letras en el orden en que se dibujan, no en el que se escriben. Así que si copias ប្រព័ន្ធ del PDF, la letra metida debajo sale primero:
Typst, una herramienta de composición tipográfica, hace el shaping con una versión de HarfBuzz y guarda las letras en el orden en que se escribieron, así que copiar y buscar funcionan. Cada PDF tarda entre 30 y 90 milisegundos en generarse. Esta es la parte de la plantilla del currículum que prepara el jemer:
// Khmer stacks marks above and below its letters, so it needs taller lines
// (as on the site) and a slightly smaller size to stay on one page.
#let pick(latin, khmer) = if km { khmer } else { latin }

#set text(
  font: ("Resume Sans Latin", "Resume Sans Khmer"),
  size: pick(9.4pt, 8.7pt),
  lang: data.lang,
)
#set par(leading: pick(0.62em, 0.86em))
pick elige el valor latino o el jemer, así que el jemer recibe un tamaño un poco menor y líneas más altas, y el currículum sigue cabiendo en una página.
Lo que le diría a quien construya en jemer
La mayoría de los arreglos fueron pequeños. Encontrarlos fue lo difícil, y solo los encuentras si miras jemer de verdad en una pantalla de verdad. Lo que haría desde el primer día:
- Prueba con palabras difíciles, no solo សួស្តី («hola»). Usa palabras que se apilan y cambian de orden, como ស្ត្រី, ប្រព័ន្ធ y ញ៉ាំ.
- Cuenta palabras con
Intl.Segmenter, nunca partiendo por los espacios. - Dale al jemer líneas más altas que al alfabeto latino, y revisa los títulos en un teléfono, donde se parten en varias líneas.
- Donde no sea un navegador quien dibuja tu texto, como en imágenes y PDFs, asegúrate de que el shaping lo haga HarfBuzz o algo construido sobre él.
- Copia el texto de vuelta de todo lo que generes y compáralo con lo que entró.
El tailandés, el lao y el birmano tampoco ponen espacios entre palabras, así que mucho de esto también les sirve. Si construyes software en uno de estos idiomas, ¿qué se te rompió a ti?
0me gusta
¡gracias!