Cómo haría hoy la revisión de pull requests
En esta página
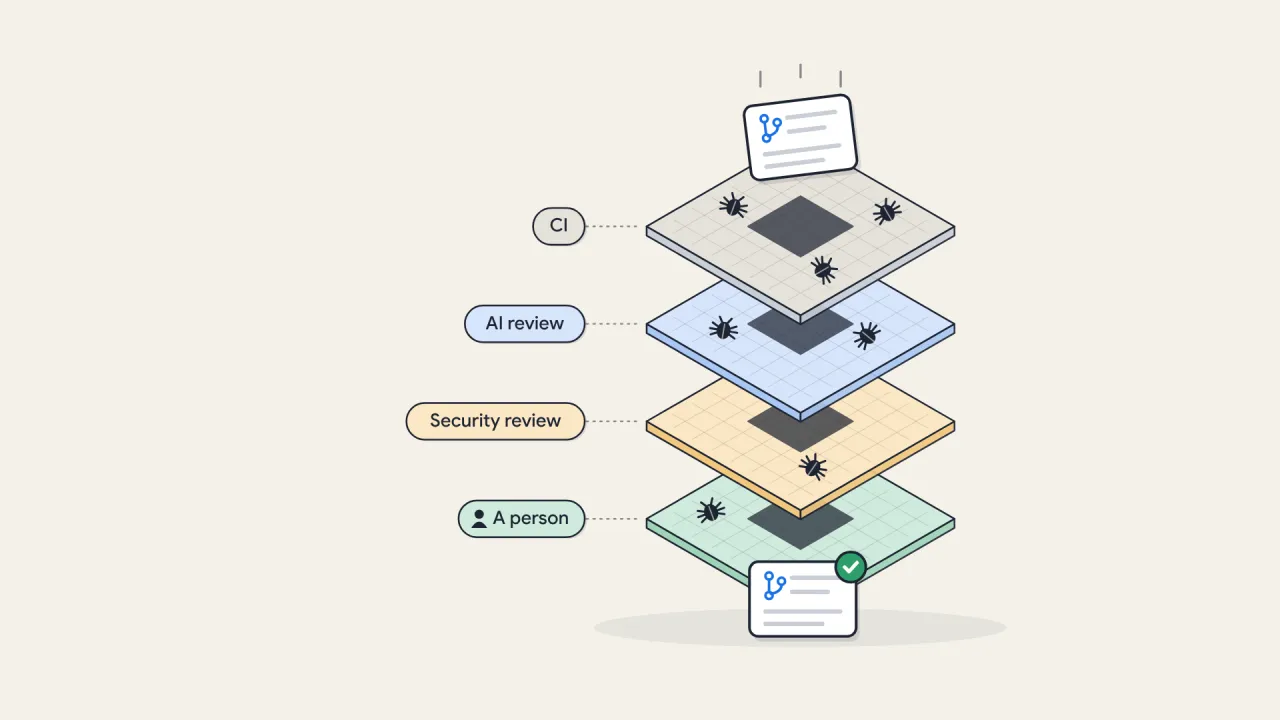
Ya no leo cada línea de código antes de que se fusione. Durante casi toda mi carrera, eso era lo que significaba revisar código. Ahora la IA escribe la mayor parte de mi código, leerlo todo ya no escala, y saltarse la revisión tampoco es una opción.
Claude escribe cerca del 90 por ciento del código del propio Claude Code, y el equipo que lo hace publicó hace poco cómo hacen la revisión de código. Así es como lo montaría yo hoy, tomando mucho de ellos.
1. Pregunta qué puede salir mal, no quién lo leyó
La frase de su artículo que se me quedó grabada: «¿lo leyó una persona?» es una forma imprecisa de preguntar «¿qué podría salir mal con este cambio, y qué control, automático o humano, es el adecuado para detectarlo?».
Cuando piensas así en la revisión, deja de ser un solo paso y se convierte en capas: la evidencia del autor, la CI, una revisión automática, una revisión de seguridad donde importa, y una persona donde el riesgo lo pide.
2. Haz de la CI el mínimo
Cada pull request pasa el lint, el chequeo de tipos, la suite completa de tests y un build, y nadie fusiona uno que esté en rojo. Los revisores, humanos o de IA, no deberían perder tiempo en nada que una máquina ya comprueba.
3. El autor demuestra que funciona antes de pedir revisión
Antes de marcar un pull request como listo, el autor, sea persona o agente, muestra que funciona: la salida de los tests, un build que pasa, y capturas de pantalla o una grabación para todo lo que tenga pantalla. «Lo ejecuté» no es evidencia. La salida sí lo es.
Pediría tres cosas en cada descripción:
- Qué cambió en el comportamiento, en unas pocas líneas que un revisor pueda leer en un minuto.
- La evidencia, incluido lo que no se comprobó. «Probado solo en inglés, no cambió ningún texto» me dice exactamente cuánto puedo fiarme de las capturas.
- El peligro de fusionarlo: ¿se puede deshacer con un simple revert, o cambia datos que un revert no va a recuperar? Y en el peor de los casos, ¿a quién afecta y cómo?
4. Deja que el cambio elija su nivel de riesgo
El riesgo viene de lo que toca un cambio, no de quién o qué lo escribió. Yo usaría tres niveles:
- Bajo: documentación, textos y traducciones. Una revisión automática, y se fusiona con la CI en verde.
- Medio: la mayoría de los cambios de producto. Una revisión automática más profunda, y una persona revisa la evidencia.
- Alto: inicio de sesión y permisos, cálculos de dinero, migraciones de base de datos, integraciones con servicios externos y scripts de CI o de despliegue. La revisión automática más profunda y además una revisión de seguridad, y una persona lee el diff.
Deja por escrito las rutas de alto riesgo, para que nadie discuta sobre ellas caso por caso. La aprobación de un agente nunca cuenta como la de una persona. Lo ideal es que dos personas lean un diff de alto riesgo. Si solo tienes una, las revisiones automáticas extra hacen las veces de la segunda.
- CI en verde
- Evidencia en la descripción de que funciona
- Una revisión automática, 1 rondaUna revisión automática más profunda, hasta 2 rondasLa revisión automática más profunda, hasta 3 rondas
- Una revisión de seguridad, no hace falta
- Ninguna persona: se fusiona con la CI en verdeUna persona revisa la evidenciaUna persona lee el diff
El cambio elige el nivel, y el nivel elige los controles.
5. Ponles un límite a las rondas de revisión
Un revisor de IA siempre puede encontrar una cosa más, y si los dejas solos, un agente autor y un agente revisor se mantienen ocupados el uno al otro toda la noche. Casi todo lo que señalan las rondas posteriores ya estaba ahí en la primera pasada.
Así que ata las rondas al nivel: una para Bajo, dos para Medio, tres para Alto. Después de la primera ronda, revisa solo lo que cambió. Corrige cada error señalado en todos los sitios donde aparece, y abre issues aparte para los problemas en código que no se tocó. Si la última ronda todavía encuentra problemas, replantea el enfoque en lugar de seguir parcheando.
El equipo de Claude Code añadió reglas parecidas, y la proporción de sus pull requests que pasaban tras una sola ronda subió del 65 al 78 por ciento.
Sin un límite, dos agentes pueden mantenerse ocupados el uno al otro toda la noche.
6. Deja que un script atrape los errores aburridos
Fíjate en lo que tu primera ronda de revisión encuentra una y otra vez. Muchas veces es mecánico: una rama que ya no se fusiona limpiamente, una descripción a la que le falta su nivel o su evidencia, una migración de base de datos que se editó después de publicarse. Nada de eso necesita un revisor de IA, y mucho menos una persona.
Un pequeño script que revise la rama y la descripción antes de que empiece la revisión atrapa todo eso. A partir de ahí, las rondas de revisión se dedican a bugs reales.
7. Convierte los bugs que se escapan en reglas
Cuando un bug se cuela en la revisión, el arreglo debería añadir lo que lo habría detectado: un test, una regla de lint o una línea en los estándares de código que lee el agente. Lo mismo cuando el revisor señala el mismo tipo de error en un segundo pull request. El pull request que lo arregla dice cuál añadió.
También mantendría una lista corta de las reglas que ya comprueba una máquina, para que los revisores confíen en esos controles y dediquen su tiempo a lo que pide criterio. Y una regla que añadiría desde el primer día: si un ticket dice que cierto comportamiento «ya existe», el pull request necesita un test que lo demuestre. A los agentes se les da muy bien creer que existe código que no existe.
8. Mantén la configuración simple
Es tentador montar un pipeline elaborado con un agente para planificar, otro para construir, otro para revisar, otro para probar y otro para juzgar las pruebas. Yo monté uno este mes, y lo tiré dos semanas después. Una sola sesión de agente haciendo todo el trabajo, con una revisión en un contexto nuevo al final, hizo lo mismo con muchas menos piezas.
Anthropic llegó a una conclusión parecida en cuándo integrar los subagentes en el bucle principal de tu agente. El único lugar donde todavía usaría un agente aparte es la revisión, porque un revisor que no escribió el código no comparte las suposiciones del autor.
9. Haz que deshacer un error sea barato
La revisión va a pasar cosas por alto. Así que haz que sea rápido apagar una integración o una funcionalidad arriesgada sin desplegar, mantén los pull requests lo bastante pequeños para revertirlos limpiamente, y explica en la descripción cómo deshacerlo.
Lo que todavía hace una persona
Una persona decide qué se construye en primer lugar. Una persona lee los diffs de alto riesgo, revisa la evidencia de todo lo demás y responde por lo que sale a producción, lo haya escrito quien lo haya escrito.
Y una persona lleva las cifras que te dicen si todo esto funciona. Si empezara hoy, la primera cifra que seguiría es la frecuencia con la que se revierten cambios ya fusionados. Si sube, no has ahorrado tiempo, solo lo has cambiado de sitio.
Si la IA también escribe la mayor parte de tu código, ¿cómo decides qué cambios todavía necesitan que una persona los lea?
0me gusta
¡gracias!Este artículo se publicó primero en linkedin.com