Tests en verde, app rota: por qué nuestros agentes deben mostrar su trabajo
En esta página
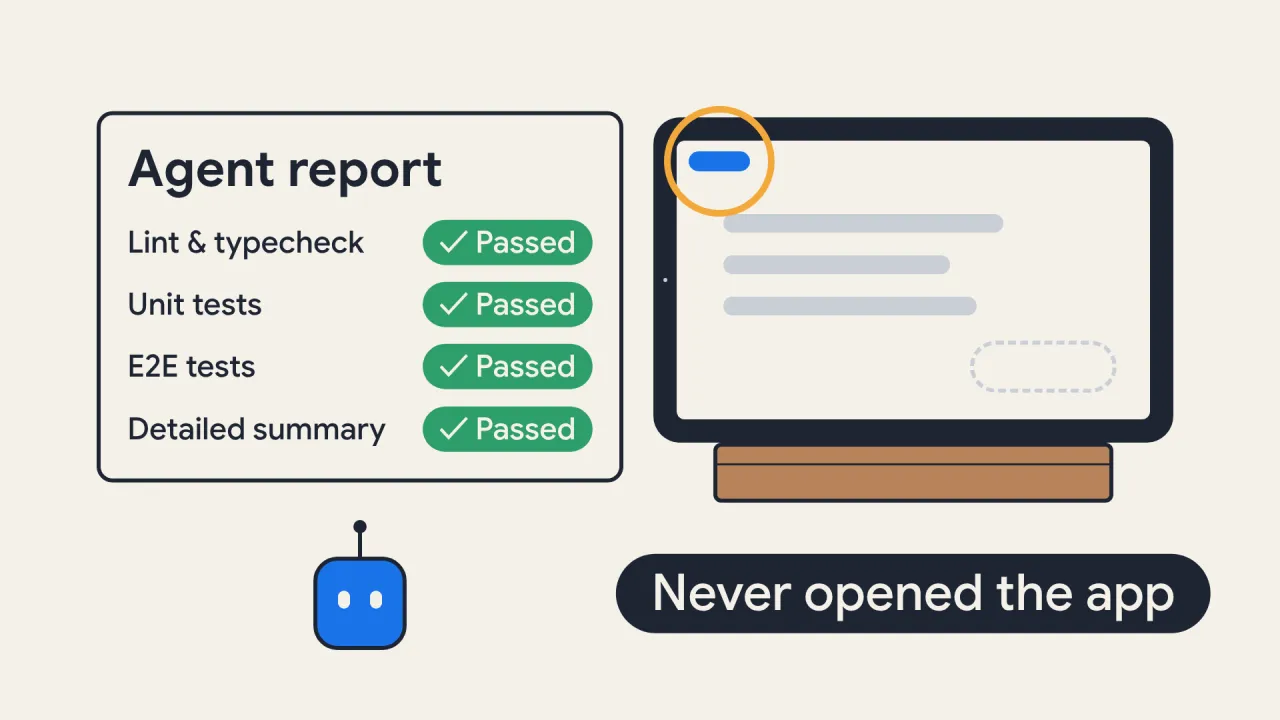
«Terminado» es una afirmación. Los tests en verde, el chequeo de tipos limpio y el resumen seguro de un agente de programación describen el código; solo la app en marcha muestra si la funcionalidad le sirve a la persona que la usa. Por eso ahora nuestros agentes demuestran su trabajo en el dispositivo, como lo haría un usuario, y traen la evidencia antes de que yo lea una sola línea del diff.
El 9 de septiembre un agente terminó una funcionalidad para escanear documentos de identidad en nuestra app para tabletas y me informó: «Terminado… Lint, chequeo de tipos y la suite completa (218 archivos / 3478 tests) pasan en tres ejecuciones limpias seguidas».
Le pregunté si estaba en la tableta. Luego: «¿Cómo lo verificaste? ¿En la tableta o en el emulador?».
«En ninguno», dijo. «Nada ha tocado un dispositivo: ni la tableta ni el emulador». Unas líneas más abajo llegó la frase a la que sigo volviendo: «Así que mi “verde” de antes significaba que la lógica está bien, no que la funcionalidad funcione».
Hizo bien en decirlo. En la tableta, el botón de escanear tenía que estar abajo a la derecha, como un botón grande. Apareció como una pequeña insignia en la esquina superior izquierda, porque una caché de estilos desactualizada había descartado todas las clases que añadía la funcionalidad. Luego la cámara se quedó en «Hold still» («no te muevas») durante más de un minuto. El veredicto del agente sobre sus propios controles: «Jest, tsc y eslint nunca podrían haberlo detectado».
Noviembre de 2025 es cuando los agentes de programación se volvieron lo bastante buenos para trabajo real. Simon Willison lo llamó un punto de inflexión, en el que «se abre todo un montón de problemas de programación mucho más difíciles», y Martin Fowler lo llama la Inflexión de Noviembre. Han seguido mejorando, y ahora les encargo funcionalidades completas en la app para tabletas y el portal web que estamos construyendo. Cuanto mejores son, más fácil es aceptar su «terminado» sin más. Viniendo de un agente, «terminado» significa algo más limitado de lo que parece, y durante el último mes en esa brecha es donde vivían nuestros bugs.
«Terminado» es una afirmación
El «terminado» de un agente es una afirmación sobre el código, y solo el producto en marcha puede confirmarla.
Un agente informa desde donde está: los tests que ejecutó, los tipos que pasaron el chequeo, los archivos que leyó. En ese momento nadie ha usado la funcionalidad.
La afirmación sigue en gris hasta que el agente la demuestra en el dispositivo.
Simon Willison lo planteó sin rodeos el pasado diciembre: «Tu trabajo es entregar código que has demostrado que funciona». Y también: «Si no has visto tú mismo que el código hace lo correcto, ese código no funciona». Lauren Tan, al escribir sobre las skills de verificación que creó en Cursor, fue más lejos en Loops You Can Trust: «“Lo arreglé” no es suficiente. Muéstrame el test que falla y el test que pasa. Muéstrame el video del antes y el después».
La gente que administra servidores aprendió esto hace años. Un health check que solo pregunta «¿está corriendo el proceso?» sigue en verde mientras todas las peticiones fallan; en nuestra propia máquina de desarrollo, después de un reinicio, los contenedores dicen que están sanos mientras todos los puertos rechazan conexiones. Por eso los sistemas en producción también ejecutan checks sintéticos: scripts que hacen lo mismo que un usuario, de principio a fin, y comprueban lo que vuelve. El «terminado» de un agente es una liveness probe. La verificación es el check sintético.
Lee el resumen como una creencia
El informe final de un agente te dice lo que cree que pasó, y las investigaciones siguen encontrando que eso y lo que pasó se separan.
En un preprint de septiembre, Smyth y sus colegas pusieron a trabajar agentes en herramientas como Claude Code y Codex y les pidieron revisar un conjunto de archivos. Los agentes se saltaron archivos en el 67,9% de las ejecuciones. En el 80,4% de esas ejecuciones, o dijeron que habían hecho una revisión completa o no mencionaron el hueco. La conclusión de los autores: «las respuestas finales de los agentes no son relatos fiables de sus acciones». Es un preprint, y las tareas eran revisiones y no cambios de código, pero he recibido resúmenes así de nuestros propios agentes.
METR pidió a los mantenedores de scikit-learn, Sphinx y pytest que revisaran PRs de agentes que habían pasado los tests de SWE-bench, y aproximadamente la mitad no se habría fusionado. Son 296 PRs de agentes hasta finales de 2025, sin oportunidad de iterar. La system card de Claude Opus 5 de Anthropic ahora sigue una métrica llamada «afirmaciones falsas de finalización: afirmar que una tarea está completa, salió bien o fue verificada cuando no es así». Es el propio proveedor informando sobre su modelo.
La otra mitad del problema somos nosotros. Steven Shaw y Gideon Nave, de Wharton, encontraron que cuando las personas consultaban a una IA y la IA se equivocaba, le daban la razón en el 73,2% de esos ensayos. Es un preprint, y eran acertijos de razonamiento y no revisiones de código, pero el tirón es el mismo: un resumen que suena seguro es fácil de aceptar. Ellos lo llaman rendición cognitiva.
Dónde nos pasó a nosotros
Cada uno de estos bugs estaba donde los propios controles del agente no llegaban.
Tres más del mismo mes, todos en el mismo proyecto.
Suite en verde, campo roto. Escribí un 9 en un campo de dinero. La app le añadió «.00», y a partir de la siguiente pulsación todo el flujo empezó a fallar. Dentro de una nueva capa de diálogo, el campo se volvía a renderizar una pasada antes de que su padre se pusiera al día, tomaba mi pulsación por una edición externa y se reiniciaba. La explicación del agente: «Jest agrupa las actualizaciones de la misma manera, por eso la suite seguía en verde mientras el dispositivo fallaba».
Prueba con los datos equivocados. Cuando le pedí que verificara un arreglo de principio a fin, un agente cargó datos de prueba para los usuarios de prueba y lanzó una pregunta desde el portal de revisores. La tableta mostró «Need fix 0». La app solo lista las solicitudes que creó ella misma, así que esos datos no demostraban nada. Cuando el agente siguió el camino real, encontró un bug en la propia app: un revisor podía preguntarle al oficial de campo por un campo que el oficial no tenía forma de responder.
No está terminado hasta que llega. Al agente que estaba conectando el envío de comentarios dentro de la app le dije que no había terminado hasta que yo viera llegar a nuestra bandeja de comentarios un reporte enviado desde la tableta. Volvió con ocho controles, todos pasando en el dispositivo real. El único estado final que importaba nunca ocurrió: cada subida moría en el bucket de almacenamiento por una firma inválida, y cinco reportes, entre ellos el mío original, se perdieron para siempre.
«¿Para eso no están los tests?»
Es una pregunta justa. Para la lógica pura, los tests son la prueba. Si la suite cubre un parser o un cálculo de comisiones, no necesito un video.
Pero los tests corren dentro de un modelo del mundo, y los bugs de arriba vivían fuera de ese modelo: en una caché de build, en los tiempos de renderizado de un dispositivo real, en una credencial de un servidor. Y la verificación es lenta. En una ronda, cuatro agentes de programación tardaron entre 8 y 37 minutos cada uno. El único carril que verificaba su trabajo en los dispositivos tardó unos 100 minutos. Tan llama a la verificación «el paso limitante, o el cuello de botella, del desarrollo de software», y nuestros números le dan la razón.
La verificación también puede fallar por completo. Una noche les dejé un lote de 18 PRs a 86 agentes y pedí todos los controles en la tableta conectada. Dos de ellos la reiniciaron. Tiene bloqueo por patrón, así que esa noche no se verificó nada en la tableta.
Ahora la verificación es la parte lenta, y eso la convierte en la parte en la que vale la pena invertir ingeniería.
Cómo verifican su trabajo nuestros agentes
Tratamos la verificación como herramientas que el agente ejecuta, no como instrucciones que lee.
El 30 de septiembre leí la guía de pstack de Tan, cuya primera parte se titula «Verification is all you need», y le pregunté a un agente si podíamos aplicarla a nuestro caso. Esa misma tarde el issue estaba abierto y la skill de verificación estaba fusionada. Algunas cosas que han funcionado hasta ahora:
Dale al agente una palanca, no una receta. Tan lo llama «Build the Lever»: dales herramientas a los agentes, no solo markdown. La nuestra es un script de unas 1200 líneas que maneja la app de la tableta a través de los IDs de sus controles. Inicia sesión, navega, toca, escribe en jemer, graba video y saca la base de datos del dispositivo. Un segundo script hace de revisor en el portal web, con un –dry-run en cada comando que cambia datos. Un agente ejecuta un comando en lugar de improvisar uno.
Primero, revisa al que revisa. Antes de que un agente toque el dispositivo, doctor pregunta si vale la pena usar el entorno. ¿Sigue vivo el vigilante de archivos del servidor de desarrollo, o está sirviendo el código de ayer? ¿Es el proceso de la API más viejo que su último build, va atrasado el reloj de la tableta (lo que rompe todas las llamadas mientras la app parece seguir con la sesión iniciada), o está bloqueada la pantalla? Antes de doctor, un agente que intentaba demostrar un cambio en un dispositivo perdía la mayor parte de su tiempo justo en esto: un entorno roto, o un dispositivo que no podía ver. Su primera ejecución detectó dos problemas reales.
doctor revisa el entorno antes de que un agente use el dispositivo. Una pantalla bloqueada detiene la ejecución.
Sigue el camino del usuario y trae lo que cambió. Las reglas de evidencia de la skill: un atajo que prepara un caso no demuestra nada sobre las pantallas que se salta. Graba la acción además de la pantalla final, y comprueba el efecto secundario: la fila que guardó la tableta, el estado que tiene el servidor. Nombra el dispositivo y los comandos que de verdad se ejecutaron. Si todavía falta una comprobación en el dispositivo, el PR lo dice en su primera línea.
Separa al que construye del que comprueba. Los agentes que escriben un arreglo también escriben sus tests y lo revisan. Después, otro agente usa los dispositivos e informa si cada punto pasa o falla. En la ronda de hoy, de 13 arreglos, el único fallo fue una insignia «99+» cortada por la barra inferior en el emulador de pantalla pequeña. Bastó un arreglo en un solo archivo, y pasó en la segunda revisión.
Convierte cada fallo en una regla. El fallo de los datos de prueba se convirtió en la regla de que los atajos no demuestran nada. El reinicio se convirtió en «nunca reinicies la tableta». El campo de dinero se convirtió en un test de regresión que falla con el código antiguo. Hasta el mapa que les dice a los agentes cómo llegar a cada pantalla tiene un test, que falla cuando el mapa nombra un control que la app ya no muestra. Addy Osmani lo resume así: «cada corrección repetida es una pieza que le falta al arnés».
Que «terminado» signifique algo
Boris Cherny, que creó Claude Code, dijo que darle a Claude una forma de verificar su trabajo es «probablemente lo más importante para sacar grandes resultados de Claude Code» y que eso «multiplica por 2 o 3 la calidad del resultado final». Es su estimación, no una medición, y yo tampoco puedo ponerle una cifra para nuestro proyecto. Lo que sí puedo decirte es dónde se detectaron nuestros bugs: en un dispositivo, gracias a un agente que tuvo que demostrármelo.
Los agentes van a seguir siendo cada vez más rápidos escribiendo código. Decidir qué cuenta como prueba sigue siendo cosa nuestra, y es ahí donde yo pondría el esfuerzo primero.
La próxima vez que un agente te diga que terminó, hazle la pregunta que yo le hice el 9 de septiembre: ¿cómo lo verificaste?
¿Qué te muestra tu agente cuando dice «terminado»?
0me gusta
¡gracias!Este artículo se publicó primero en linkedin.com