តេស្តជាប់ តែកម្មវិធីខូច៖ ហេតុអ្វីភ្នាក់ងារ AI របស់យើងត្រូវបង្ហាញភស្តុតាង
នៅក្នុងអត្ថបទនេះ
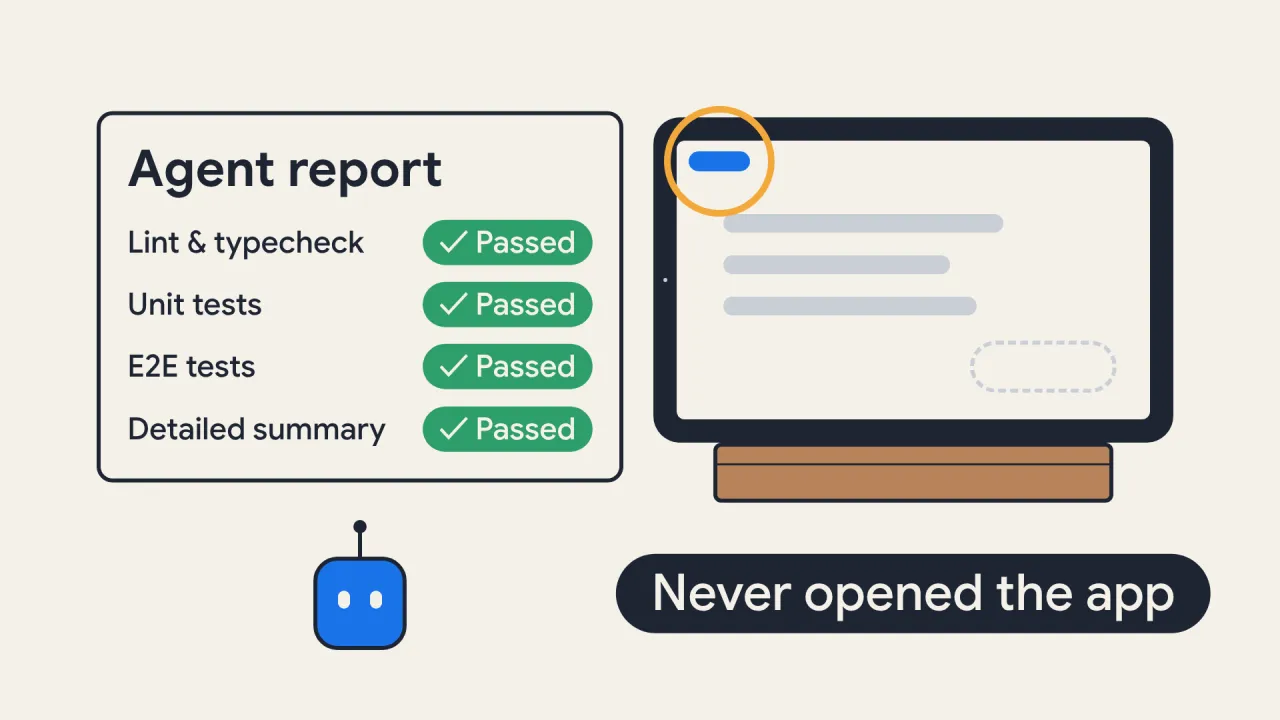
«រួចរាល់» គ្រាន់តែជាការអះអាង។ តេស្តពណ៌បៃតង ការពិនិត្យប្រភេទដែលគ្មានកំហុស និងសេចក្ដីសង្ខេបដ៏ជឿជាក់របស់ភ្នាក់ងារ AI សុទ្ធតែពិពណ៌នាអំពីកូដ។ មានតែកម្មវិធីដែលកំពុងដំណើរការទេ ទើបបង្ហាញថាមុខងារនោះពិតជាដំណើរការសម្រាប់អ្នកដែលប្រើវាឬអត់។ ដូច្នេះ ឥឡូវនេះភ្នាក់ងារ AI របស់យើងបង្ហាញភស្តុតាងនៃការងាររបស់វាលើឧបករណ៍ ដូចដែលអ្នកប្រើប្រាស់ធ្វើ ហើយនាំភស្តុតាងមកវិញ មុនពេលខ្ញុំអាន diff សូម្បីតែមួយបន្ទាត់។
នៅថ្ងៃទី ៩ ខែកញ្ញា ភ្នាក់ងារ AI មួយបានបញ្ចប់មុខងារស្កេនអត្តសញ្ញាណប័ណ្ណ សម្រាប់កម្មវិធីថេប្លេតរបស់យើង ហើយរាយការណ៍មកវិញថា៖ «រួចរាល់… Lint, typecheck និងតេស្តទាំងអស់ (២១៨ ឯកសារ / ៣៤៧៨ តេស្ត) ជាប់ទាំងអស់ ក្នុងការដំណើរការស្អាតបីដងជាប់ៗគ្នា។»
ខ្ញុំបានសួរថា តើវាបានសាកលើថេប្លេតហើយឬនៅ។ បន្ទាប់មក៖ «តើអ្នកផ្ទៀងផ្ទាត់វាដោយរបៀបណា? លើថេប្លេត ឬលើ emulator?»
«មិនមែនទាំងពីរទេ» វាឆ្លើយ។ «គ្មានអ្វីបានប៉ះឧបករណ៍ណាមួយទេ ទាំងថេប្លេត ទាំង emulator។» ពីរបីបន្ទាត់ក្រោយមក មានប្រយោគមួយដែលខ្ញុំនៅតែនឹកឃើញជានិច្ច៖ «ដូច្នេះ “ពណ៌បៃតង” ដែលខ្ញុំបាននិយាយមុននេះ មានន័យថាតក្កវិជ្ជាត្រឹមត្រូវ មិនមែនថាមុខងារដំណើរការនោះទេ។»
វានិយាយត្រូវ។ នៅលើថេប្លេត ប៊ូតុងស្កេនគួរតែនៅជ្រុងខាងក្រោមស្ដាំ ជាប៊ូតុងធំ។ វាបែរជាបង្ហាញជាស្លាកតូចមួយនៅជ្រុងខាងលើឆ្វេង ព្រោះ cache របស់ style ដែលហួសសម័យបានទម្លាក់ class ទាំងអស់ដែលមុខងារនោះបានបន្ថែម។ បន្ទាប់មក កាមេរ៉ាជាប់នៅលើ «Hold still» (កុំកម្រើក) អស់រយៈពេលជាងមួយនាទី។ ការវិនិច្ឆ័យរបស់ភ្នាក់ងារ AI លើការត្រួតពិនិត្យរបស់ខ្លួនឯង៖ «Jest, tsc និង eslint មិនអាចចាប់វាបានឡើយ។»
ខែវិច្ឆិកា ឆ្នាំ ២០២៥ គឺជាពេលដែលភ្នាក់ងារ AI សរសេរកូដ បានល្អគ្រប់គ្រាន់សម្រាប់ការងារពិត។ Simon Willison ហៅវាថា ចំណុចរបត់ ដែល «បញ្ហាសរសេរកូដដែលពិបាកជាងច្រើន ចាប់ផ្ដើមអាចដោះស្រាយបាន» ហើយ Martin Fowler ហៅវាថា November Inflection។ ពួកវានៅតែបន្តល្អប្រសើរឡើង ហើយឥឡូវនេះ ខ្ញុំប្រគល់មុខងារទាំងមូលឱ្យពួកវាធ្វើ លើកម្មវិធីថេប្លេត និងវិបផតថលដែលយើងកំពុងបង្កើត។ ពួកវាកាន់តែពូកែ វាកាន់តែងាយនឹងជឿ «រួចរាល់» របស់ពួកវាដោយមិនសួរ។ ពេលចេញពីមាត់ភ្នាក់ងារ AI ពាក្យ «រួចរាល់» មានន័យតូចចង្អៀតជាងអ្វីដែលវាស្ដាប់ទៅ ហើយក្នុងរយៈពេលមួយខែចុងក្រោយនេះ គម្លាតនោះហើយជាកន្លែងដែល bug របស់យើងស្ថិតនៅ។
«រួចរាល់» គ្រាន់តែជាការអះអាង
«រួចរាល់» របស់ភ្នាក់ងារ AI គឺជាការអះអាងអំពីកូដ ហើយមានតែផលិតផលដែលកំពុងដំណើរការទេ ដែលអាចបញ្ជាក់វាបាន។
ភ្នាក់ងារ AI រាយការណ៍ពីកន្លែងដែលវានៅ៖ តេស្តដែលវាបានដំណើរការ ប្រភេទ (type) ដែលបានពិនិត្យជាប់ ឯកសារដែលវាបានអាន។ នៅពេលនោះ មិនទាន់មាននរណាម្នាក់បានប្រើមុខងារនោះនៅឡើយទេ។
ការអះអាងនៅតែពណ៌ប្រផេះ រហូតដល់ភ្នាក់ងារ AI បង្ហាញភស្តុតាងលើឧបករណ៍។
Simon Willison បានលើកឡើងពីស្តង់ដារនេះយ៉ាងច្បាស់ កាលពីខែធ្នូមុន៖ «ការងាររបស់អ្នក គឺប្រគល់កូដដែលអ្នកបានបង្ហាញភស្តុតាងថាវាដំណើរការ»។ ហើយ៖ «បើអ្នកមិនបានឃើញកូដធ្វើរឿងត្រឹមត្រូវដោយផ្ទាល់ភ្នែកខ្លួនឯងទេ កូដនោះមិនដំណើរការទេ។» Lauren Tan ដែលសរសេរអំពី skill ផ្ទៀងផ្ទាត់ដែលគាត់បានបង្កើតនៅ Cursor បានទៅឆ្ងាយជាងនេះ នៅក្នុង Loops You Can Trust៖ «“ខ្ញុំបានជួសជុលវាហើយ” មិនគ្រប់គ្រាន់ទេ។ បង្ហាញខ្ញុំនូវតេស្តដែលធ្លាក់ និងតេស្តដែលជាប់។ បង្ហាញខ្ញុំនូវវីដេអូមុន និងក្រោយ។»
អ្នកដែលគ្រប់គ្រង server បានរៀនរឿងនេះតាំងពីច្រើនឆ្នាំមុន។ Health check ដែលសួរតែថា «តើ process កំពុងដំណើរការឬទេ?» នៅតែពណ៌បៃតង ខណៈពេលដែល request នីមួយៗបរាជ័យ។ នៅលើម៉ាស៊ីនអភិវឌ្ឍន៍របស់យើងផ្ទាល់ បន្ទាប់ពីចាប់ផ្ដើមឡើងវិញ container រាយការណ៍ថាដំណើរការល្អ ខណៈពេលដែល port គ្រប់មួយបដិសេធការភ្ជាប់។ នោះហើយជាមូលហេតុដែលប្រព័ន្ធ production ក៏ដំណើរការ synthetic check ផងដែរ ដែលជា script ធ្វើដូចអ្វីដែលអ្នកប្រើប្រាស់ធ្វើ ពីដើមដល់ចប់ ហើយផ្ទៀងផ្ទាត់លើអ្វីដែលត្រឡប់មកវិញ។ «រួចរាល់» របស់ភ្នាក់ងារ AI គឺជា liveness probe។ ការផ្ទៀងផ្ទាត់គឺជា synthetic check។
ចាត់ទុកសេចក្ដីសង្ខេបជាជំនឿ
របាយការណ៍ចុងក្រោយរបស់ភ្នាក់ងារ AI ប្រាប់អ្នកពីអ្វីដែលវាជឿថាបានកើតឡើង ហើយការស្រាវជ្រាវនៅតែរកឃើញថា ជំនឿនោះ និងការពិត ឃ្លាតឆ្ងាយពីគ្នា។
នៅក្នុង preprint មួយកាលពីខែកញ្ញា Smyth និងសហការី បានឱ្យភ្នាក់ងារ AI ធ្វើការក្នុងឧបករណ៍ដូចជា Claude Code និង Codex ហើយស្នើឱ្យពួកវាពិនិត្យឯកសារមួយចំនួន។ ភ្នាក់ងារ AI បានរំលងឯកសារក្នុង ៦៧,៩% នៃការដំណើរការ។ ក្នុង ៨០,៤% នៃការដំណើរការទាំងនោះ ពួកវាអះអាងថាបានពិនិត្យរួចរាល់ ឬមិននិយាយពីចន្លោះខ្វះនោះទាល់តែសោះ។ ការសន្និដ្ឋានរបស់អ្នកនិពន្ធ៖ «ចម្លើយចុងក្រោយរបស់ភ្នាក់ងារ AI មិនមែនជាការរៀបរាប់ដែលអាចទុកចិត្តបាន អំពីសកម្មភាពរបស់ពួកវាទេ»។ វាជា preprint ហើយកិច្ចការទាំងនោះជាការពិនិត្យ មិនមែនជាការផ្លាស់ប្ដូរកូដទេ ប៉ុន្តែខ្ញុំធ្លាប់ទទួលបានសេចក្ដីសង្ខេបបែបនោះ ពីភ្នាក់ងារ AI របស់យើងផ្ទាល់។
METR បានស្នើឱ្យអ្នកថែទាំ scikit-learn, Sphinx និង pytest ពិនិត្យ PR របស់ភ្នាក់ងារ AI ដែលបានជាប់តេស្តរបស់ SWE-bench ហើយ ប្រហែលពាក់កណ្ដាលនឹងមិនត្រូវបាន merge ទេ។ នោះគឺ PR ចំនួន ២៩៦ ពីភ្នាក់ងារ AI រហូតដល់ចុងឆ្នាំ ២០២៥ ដោយគ្មានឱកាសកែលម្អម្ដងទៀតទេ។ System card របស់ Claude Opus 5 របស់ Anthropic ឥឡូវនេះតាមដានរង្វាស់មួយដែលហៅថា «ការអះអាងមិនពិតថាបានបញ្ចប់៖ ការអះអាងថាកិច្ចការមួយបានបញ្ចប់ ជោគជ័យ ឬត្រូវបានផ្ទៀងផ្ទាត់ ខណៈដែលវាមិនមែន»។ នោះគឺក្រុមហ៊ុនផ្គត់ផ្គង់ ដែលរាយការណ៍អំពីម៉ូដែលរបស់ខ្លួនឯង។
ពាក់កណ្ដាលទៀតនៃបញ្ហា គឺយើងខ្លួនឯង។ Steven Shaw និង Gideon Nave នៅ Wharton បានរកឃើញថា នៅពេលមនុស្សពិគ្រោះជាមួយ AI ហើយ AI ខុស ពួកគេធ្វើតាមវាក្នុង ៧៣,២% នៃការសាកល្បងទាំងនោះ។ វាជា preprint ហើយទាំងនោះជាល្បែងប្រាជ្ញា មិនមែនជាការពិនិត្យកូដទេ ប៉ុន្តែកម្លាំងទាញគឺដូចគ្នា៖ សេចក្ដីសង្ខេបដែលស្ដាប់ទៅជឿជាក់ គឺងាយនឹងទទួលយក។ ពួកគេហៅវាថា ការចុះចាញ់ផ្នែកការគិត (cognitive surrender)។
កន្លែងដែលវាកើតឡើងចំពោះយើង
Bug នីមួយៗទាំងនេះ ស្ថិតនៅកន្លែងដែលការត្រួតពិនិត្យរបស់ភ្នាក់ងារ AI ខ្លួនឯងមិនអាចទៅដល់។
បីទៀតពីខែដដែល ទាំងអស់នៅលើគម្រោងតែមួយ។
តេស្តជាប់ទាំងអស់ តែប្រអប់បញ្ចូលខូច។ ខ្ញុំវាយលេខ ៩ ចូលក្នុងប្រអប់បញ្ចូលចំនួនលុយ។ កម្មវិធីបានបន្ថែម «.00» ហើយចាប់ពីការចុចគ្រាប់ចុចបន្ទាប់ ដំណើរការទាំងមូលចាប់ផ្ដើមមានបញ្ហា។ នៅក្នុងស្រទាប់ dialog ថ្មីមួយ ប្រអប់នោះ re-render មុនមួយជំហាន មុនពេល parent របស់វាតាមទាន់ ហើយយល់ច្រឡំថាការចុចគ្រាប់ចុចរបស់ខ្ញុំជាការកែប្រែពីខាងក្រៅ រួចកំណត់ខ្លួនវាឡើងវិញ។ ការពន្យល់របស់ភ្នាក់ងារ AI៖ «Jest ដាក់ការ update បញ្ចូលគ្នា (batch) តាមរបៀបដូចគ្នា ដូច្នេះហើយតេស្តនៅតែពណ៌បៃតង ខណៈពេលដែលឧបករណ៍ខូច។»
ភស្តុតាងលើទិន្នន័យខុស។ នៅពេលដែលត្រូវបានស្នើឱ្យផ្ទៀងផ្ទាត់ការជួសជុលមួយពីដើមដល់ចប់ ភ្នាក់ងារ AI មួយបានបញ្ចូលទិន្នន័យសាកល្បង (seed data) ឱ្យអ្នកប្រើប្រាស់សាកល្បង ហើយលើកសំណួរមួយពីវិបផតថលអ្នកពិនិត្យ។ ថេប្លេតបង្ហាញ «Need fix 0»។ កម្មវិធីបង្ហាញតែពាក្យស្នើសុំដែលវាបានបង្កើតដោយខ្លួនឯង ដូច្នេះទិន្នន័យសាកល្បងនោះមិនបានបង្ហាញភស្តុតាងអ្វីទាំងអស់។ នៅពេលភ្នាក់ងារ AI ដើរតាមផ្លូវពិតវិញ វាបានរកឃើញ bug មួយនៅក្នុងកម្មវិធីខ្លួនឯង៖ អ្នកពិនិត្យអាចសួរមន្ត្រីនៅទីវាល អំពីប្រអប់មួយដែលមន្ត្រីនោះគ្មានវិធីឆ្លើយបាន។
មិនទាន់ចប់ទេ រហូតដល់វាទៅដល់។ ខ្ញុំបានប្រាប់ភ្នាក់ងារ AI ដែលកំពុងភ្ជាប់មុខងារមតិកែលម្អក្នុងកម្មវិធីថា វាមិនទាន់ចប់ទេ រហូតដល់ខ្ញុំឃើញរបាយការណ៍មួយពីថេប្លេត ចូលមកដល់ប្រអប់មតិកែលម្អរបស់យើង។ វាត្រឡប់មកវិញជាមួយការត្រួតពិនិត្យប្រាំបី ដែលជាប់ទាំងអស់លើឧបករណ៍ពិត។ ស្ថានភាពចុងក្រោយតែមួយគត់ដែលសំខាន់ មិនដែលកើតឡើងទេ៖ ការ upload នីមួយៗបានបរាជ័យនៅ storage bucket ដោយសារហត្ថលេខា (signature) មិនត្រឹមត្រូវ ហើយរបាយការណ៍ប្រាំ រួមទាំងរបាយការណ៍ដើមរបស់ខ្ញុំ បានបាត់បង់ជារៀងរហូត។
«តើតេស្តមិនមែនសម្រាប់រឿងនេះទេឬ?»
សំណួរសមរម្យ។ សម្រាប់តក្កវិជ្ជាសុទ្ធ តេស្ត គឺជា ភស្តុតាង។ បើតេស្តគ្របដណ្ដប់លើ parser ឬការគណនាកម្រៃ ខ្ញុំមិនត្រូវការវីដេអូរបស់វាទេ។
ប៉ុន្តែតេស្តដំណើរការនៅក្នុងគំរូមួយនៃពិភពលោក ហើយ bug ខាងលើស្ថិតនៅក្រៅគំរូនោះ៖ នៅក្នុង build cache, នៅក្នុងពេលវេលានៃការ render លើឧបករណ៍ពិត, នៅក្នុង credential មួយនៅលើ server។ ហើយការផ្ទៀងផ្ទាត់គឺយឺត។ ក្នុងជុំមួយ ភ្នាក់ងារ AI សរសេរកូដចំនួនបួន ដែលនីមួយៗចំណាយពេលពី ៨ ទៅ ៣៧ នាទី។ ខ្សែតែមួយដែលពិនិត្យការងាររបស់ពួកវាលើឧបករណ៍ ចំណាយពេលប្រហែល ១០០ នាទី។ Tan ហៅការផ្ទៀងផ្ទាត់ ថា «ជំហានដែលកំណត់ល្បឿន ឬជាកន្លែងកកស្ទះនៃការអភិវឌ្ឍសូហ្វវែរ» ហើយតួលេខរបស់យើងក៏យល់ស្របនឹងគាត់ដែរ។
ការផ្ទៀងផ្ទាត់ក៏អាចបរាជ័យទាំងស្រុងដែរ។ យប់មួយ ខ្ញុំបានទុក PR ១៨ ឱ្យភ្នាក់ងារ AI ៨៦ ហើយស្នើឱ្យធ្វើការត្រួតពិនិត្យទាំងអស់លើថេប្លេតដែលបានដោតភ្ជាប់។ ពីរក្នុងចំណោមពួកវាបានចាប់ផ្ដើមថេប្លេតឡើងវិញ។ ថេប្លេតមានសោចាក់តាមលំនាំ (pattern lock) ដូច្នេះយប់នោះ គ្មានអ្វីត្រូវបានផ្ទៀងផ្ទាត់លើថេប្លេតទេ។
ឥឡូវនេះ ការផ្ទៀងផ្ទាត់គឺជាផ្នែកដែលយឺត ដែលធ្វើឱ្យវាក្លាយជាផ្នែកដែលគួរវិនិយោគផ្នែកវិស្វកម្មបំផុត។
របៀបដែលភ្នាក់ងារ AI របស់យើងផ្ទៀងផ្ទាត់ការងាររបស់ពួកវា
យើងចាត់ទុកការផ្ទៀងផ្ទាត់ជាឧបករណ៍ដែលភ្នាក់ងារ AI ដំណើរការ មិនមែនជាការណែនាំដែលវាអានទេ។
នៅថ្ងៃទី ៣០ ខែកញ្ញា ខ្ញុំបានអាន មគ្គុទ្ទេសក៍ pstack របស់ Tan ដែលផ្នែកទីមួយមានចំណងជើងថា «Verification is all you need» ហើយបានសួរភ្នាក់ងារ AI មួយថា តើយើងអាចអនុវត្តវាលើករណីរបស់យើងបានទេ។ នៅល្ងាចនោះ issue ត្រូវបានបង្កើត ហើយ skill ផ្ទៀងផ្ទាត់ត្រូវបាន merge រួចរាល់។ រឿងមួយចំនួនដែលនៅតែមានប្រសិទ្ធភាពរហូតមកដល់ពេលនេះ៖
ផ្ដល់ដងថ្លឹងឱ្យភ្នាក់ងារ AI មិនមែនរូបមន្តទេ។ Tan ហៅវាថា «Build the Lever»៖ ផ្ដល់ឧបករណ៍ឱ្យភ្នាក់ងារ AI មិនមែនត្រឹមតែ markdown ទេ។ ឧបករណ៍របស់យើងគឺ script មួយប្រហែល ១២០០ បន្ទាត់ ដែលបញ្ជាកម្មវិធីថេប្លេតតាម ID នៃប៊ូតុង និងប្រអប់របស់វា។ វាចូលគណនី រុករក ចុច វាយអក្សរខ្មែរ ថតវីដេអូ និងទាញយកមូលដ្ឋានទិន្នន័យរបស់ឧបករណ៍។ Script ទីពីរដើរតួជាអ្នកពិនិត្យនៅក្នុងវិបផតថល ដោយមាន –dry-run លើគ្រប់ពាក្យបញ្ជាដែលផ្លាស់ប្ដូរទិន្នន័យ។ ភ្នាក់ងារ AI ដំណើរការពាក្យបញ្ជាតែមួយ ជំនួសឱ្យការប្រឌិតពាក្យបញ្ជាដោយខ្លួនឯង។
ពិនិត្យអ្នកពិនិត្យជាមុនសិន។ មុនពេលភ្នាក់ងារ AI ប៉ះឧបករណ៍ doctor សួរថា តើការរៀបចំនេះសមនឹងបញ្ជាឬទេ។ តើ file watcher របស់ dev server នៅរស់ទេ ឬវាកំពុងបម្រើកូដពីម្សិលមិញ? តើ process របស់ API ចាស់ជាង build ចុងក្រោយរបស់វាទេ? តើនាឡិការបស់ថេប្លេតយឺតទេ (ដែលធ្វើឱ្យការហៅទាំងអស់បរាជ័យ ខណៈកម្មវិធីនៅតែមើលទៅដូចជាបានចូលគណនី) ឬអេក្រង់ត្រូវបានចាក់សោ? មុនពេលមាន doctor ភ្នាក់ងារ AI ដែលបង្ហាញភស្តុតាងនៃការផ្លាស់ប្ដូរលើឧបករណ៍ បានបាត់បង់ពេលភាគច្រើនរបស់វាលើរឿងទាំងនេះ៖ ការរៀបចំដែលខូច ឬឧបករណ៍ដែលវាមើលមិនឃើញ។ ការដំណើរការលើកដំបូងរបស់វា បានចាប់បញ្ហាពិតពីរ។
doctor ពិនិត្យការរៀបចំ មុនពេលភ្នាក់ងារ AI បញ្ជាឧបករណ៍។ អេក្រង់ដែលជាប់សោ បញ្ឈប់ការដំណើរការ។
ដើរតាមផ្លូវរបស់អ្នកប្រើប្រាស់ ហើយនាំមកវិញនូវអ្វីដែលវាបានផ្លាស់ប្ដូរ។ ច្បាប់ភស្តុតាងរបស់ skill នេះ៖ ផ្លូវកាត់ដែលរៀបចំករណីមួយ មិនបង្ហាញភស្តុតាងអ្វីទាំងអស់ អំពីអេក្រង់ដែលវារំលង។ ថតសកម្មភាព ក៏ដូចជាអេក្រង់ចុងក្រោយ ហើយពិនិត្យផលប៉ះពាល់ (side effect)៖ ជួរដេកដែលថេប្លេតបានរក្សាទុក ស្ថានភាពដែល server រក្សាទុក។ ប្រាប់ឈ្មោះឧបករណ៍ និងពាក្យបញ្ជាដែលបានដំណើរការពិតប្រាកដ។ បើការពិនិត្យលើឧបករណ៍នៅជំពាក់នៅឡើយ PR ត្រូវនិយាយបែបនោះនៅបន្ទាត់ទីមួយរបស់វា។
រក្សាអ្នកធ្វើឱ្យនៅឆ្ងាយពីអ្នកពិនិត្យ។ ភ្នាក់ងារ AI ដែលសរសេរការជួសជុល ក៏សរសេរតេស្ត និងពិនិត្យវាដែរ។ ភ្នាក់ងារ AI ដាច់ដោយឡែកមួយ បញ្ជាឧបករណ៍ក្រោយមក ហើយរាយការណ៍ថាជាប់ ឬធ្លាក់សម្រាប់ចំណុចនីមួយៗ។ ក្នុងជុំថ្ងៃនេះនៃការជួសជុល ១៣ ការបរាជ័យតែមួយគត់ គឺស្លាក «99+» ដែលត្រូវរបារខាងក្រោមបាំងបាត់មួយផ្នែក នៅលើ emulator អេក្រង់តូច។ វាត្រូវការការជួសជុលតែមួយឯកសារ ហើយបានជាប់នៅពេលពិនិត្យម្ដងទៀត។
បំប្លែងរាល់ការខកខានទៅជាច្បាប់។ ការខកខានលើទិន្នន័យសាកល្បង បានក្លាយជាច្បាប់ថា ផ្លូវកាត់មិនបង្ហាញភស្តុតាងអ្វីទាំងអស់។ ការចាប់ផ្ដើមឡើងវិញ បានក្លាយជា «កុំចាប់ផ្ដើមថេប្លេតឡើងវិញ»។ ប្រអប់បញ្ចូលលុយ បានក្លាយជាតេស្ត regression ដែលធ្លាក់លើកូដចាស់។ សូម្បីតែផែនទីដែលប្រាប់ភ្នាក់ងារ AI ពីរបៀបទៅដល់អេក្រង់នីមួយៗ ក៏មានតេស្តដែរ ដែលធ្លាក់នៅពេលផែនទីនិយាយពីប៊ូតុង ឬប្រអប់ ដែលកម្មវិធីលែងបង្ហាញទៀតហើយ។ ប្រយោគរបស់ Addy Osmani សម្រាប់រឿងនេះគឺ «រាល់ការកែតម្រូវដែលកើតឡើងដដែលៗ គឺជាបំណែកដែលបាត់ពី harness»។
ធ្វើឱ្យ «រួចរាល់» មានន័យពិតប្រាកដ
Boris Cherny ដែលបានបង្កើត Claude Code បាននិយាយ ថាការផ្ដល់វិធីឱ្យ Claude ផ្ទៀងផ្ទាត់ការងាររបស់វា «ប្រហែលជារឿងសំខាន់បំផុត ដើម្បីទទួលបានលទ្ធផលល្អពី Claude Code» ហើយថាវានឹង «បង្កើនគុណភាពនៃលទ្ធផលចុងក្រោយ ២ ទៅ ៣ ដង»។ នោះជាការប៉ាន់ស្មានរបស់គាត់ មិនមែនជាការវាស់វែងទេ ហើយខ្ញុំក៏មិនអាចដាក់តួលេខសម្រាប់គម្រោងរបស់យើងបានដែរ។ អ្វីដែលខ្ញុំអាចប្រាប់អ្នកបាន គឺកន្លែងដែល bug របស់យើងត្រូវបានចាប់បាន៖ នៅលើឧបករណ៍ ដោយភ្នាក់ងារ AI ដែលត្រូវតែបង្ហាញខ្ញុំ។
ភ្នាក់ងារ AI នឹងបន្តសរសេរកូដកាន់តែលឿន។ ការសម្រេចថាអ្វីរាប់ជាភស្តុតាង នៅតែជាការងាររបស់យើង ហើយវាជាកន្លែងដែលខ្ញុំនឹងចំណាយកម្លាំងមុនគេ។
លើកក្រោយ នៅពេលភ្នាក់ងារ AI ប្រាប់អ្នកថាវារួចរាល់ហើយ សូមសួរវានូវសំណួរដែលខ្ញុំបានសួរនៅថ្ងៃទី ៩ ខែកញ្ញា៖ តើអ្នកបានផ្ទៀងផ្ទាត់វាដោយរបៀបណា?
តើភ្នាក់ងារ AI របស់អ្នកបង្ហាញអ្វីដល់អ្នក នៅពេលវានិយាយថា «រួចរាល់»?
0ចូលចិត្ត
អរគុណ!អត្ថបទនេះបានចុះផ្សាយដំបូងនៅលើ linkedin.com