របៀបដែលខ្ញុំនឹងពិនិត្យ pull request នៅសព្វថ្ងៃ
នៅក្នុងអត្ថបទនេះ
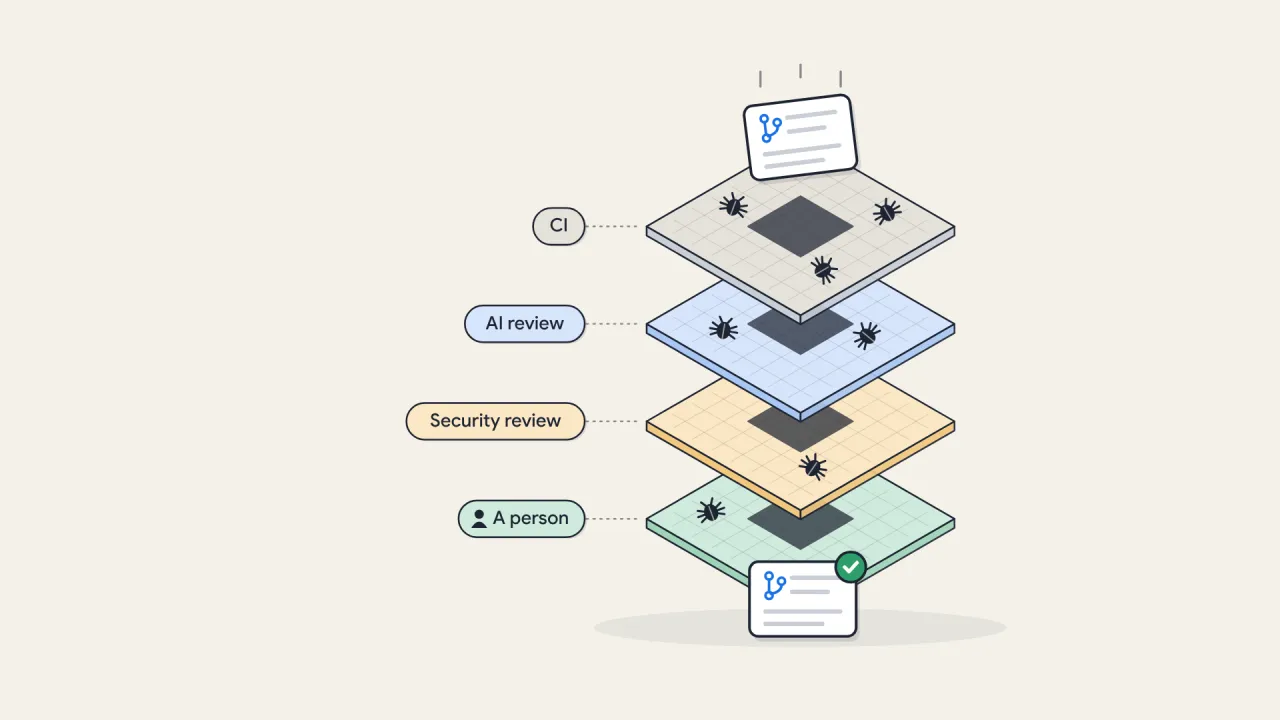
ខ្ញុំលែងអានកូដគ្រប់បន្ទាត់ មុនពេលវាត្រូវបាន merge ទៀតហើយ។ ក្នុងអាជីពការងាររបស់ខ្ញុំភាគច្រើន នោះហើយជាអត្ថន័យនៃការពិនិត្យកូដ។ ឥឡូវនេះ AI សរសេរកូដរបស់ខ្ញុំភាគច្រើន ការអានវាទាំងអស់លែងធ្វើទាន់ទៀតហើយ ហើយការរំលងការពិនិត្យក៏មិនមែនជាជម្រើសដែរ។
Claude សរសេរប្រមាណ ៩០ ភាគរយនៃកូដរបស់ Claude Code ខ្លួនឯង ហើយក្រុមដែលបង្កើតវា ទើបតែបានចុះផ្សាយ របៀបដែលពួកគេពិនិត្យកូដ។ នេះជារបៀបដែលខ្ញុំនឹងរៀបចំវានៅថ្ងៃនេះ ដោយខ្ចីគំនិតជាច្រើនពីពួកគេ។
១. សួរថាអ្វីអាចខុស មិនមែនសួរថាអ្នកណាបានអានវា
ប្រយោគមួយពីអត្ថបទរបស់ពួកគេ ដែលខ្ញុំចាំមិនភ្លេច៖ សំណួរ «តើមនុស្សបានអានកូដហើយឬនៅ?» គ្រាន់តែជាការជំនួសមិនច្បាស់លាស់ ឱ្យសំណួរ «តើអ្វីអាចខុសជាមួយការផ្លាស់ប្ដូរនេះ ហើយការត្រួតពិនិត្យមួយណា ទោះជាស្វ័យប្រវត្តិ ឬដោយមនុស្ស ដែលសមស្របបំផុតដើម្បីចាប់វាបាន?»។
នៅពេលអ្នកគិតអំពីការពិនិត្យតាមរបៀបនោះ វាលែងជាជំហានតែមួយ ហើយក្លាយជាស្រទាប់ជាច្រើន៖ ភស្តុតាងពីអ្នកសរសេរ, CI, ការពិនិត្យស្វ័យប្រវត្តិ, ការពិនិត្យសុវត្ថិភាពនៅកន្លែងដែលសំខាន់ និងមនុស្សម្នាក់នៅកន្លែងដែលហានិភ័យទាមទារ។
២. ធ្វើឱ្យ CI ជាកម្រិតអប្បបរមា
Pull request នីមួយៗ ត្រូវឆ្លងកាត់ lint, ការពិនិត្យប្រភេទ (type check), តេស្តទាំងអស់ និង build ហើយគ្មាននរណាម្នាក់ merge pull request ដែលបរាជ័យ (ពណ៌ក្រហម) នោះទេ។ អ្នកពិនិត្យ ទោះជាមនុស្ស ឬ AI មិនគួរចំណាយពេលលើអ្វីដែលម៉ាស៊ីនបានពិនិត្យរួចហើយនោះទេ។
៣. អ្នកសរសេរបង្ហាញថាវាដំណើរការ មុនពេលស្នើឱ្យពិនិត្យ
មុនពេល pull request មួយត្រូវបានសម្គាល់ថារួចរាល់ អ្នកសរសេរ ទោះជាមនុស្ស ឬភ្នាក់ងារ AI ក៏ដោយ ត្រូវបង្ហាញថាវាដំណើរការ៖ លទ្ធផលតេស្ត, build ដែលជាប់ និងរូបថតអេក្រង់ ឬវីដេអូថត សម្រាប់អ្វីៗដែលមានអេក្រង់។ «ខ្ញុំបានដំណើរការវាហើយ» មិនមែនជាភស្តុតាងទេ។ លទ្ធផលទើបជាភស្តុតាង។
ខ្ញុំនឹងស្នើឱ្យមានបីយ៉ាងក្នុងការពិពណ៌នានីមួយៗ៖
- អ្វីដែលបានផ្លាស់ប្ដូរក្នុងរបៀបដែលកម្មវិធីដំណើរការ ជាពីរបីបន្ទាត់ ដែលអ្នកពិនិត្យអាចអានបានក្នុងមួយនាទី។
- ភស្តុតាង រួមទាំងអ្វីដែលមិនបានពិនិត្យ។ «បានសាកល្បងតែជាភាសាអង់គ្លេស មិនមានអក្សរណាផ្លាស់ប្ដូរ» ប្រាប់ខ្ញុំយ៉ាងច្បាស់ថា ខ្ញុំគួរទុកចិត្តរូបថតអេក្រង់ប៉ុណ្ណា។
- គ្រោះថ្នាក់នៃការ merge៖ តើការ revert ធម្មតាអាចលុបវាវិញបានទេ ឬវាផ្លាស់ប្ដូរទិន្នន័យដែល revert មិនអាចយកមកវិញបាន? ហើយក្នុងករណីអាក្រក់បំផុត តើអ្នកណារងផលប៉ះពាល់ ហើយយ៉ាងដូចម្ដេច?
៤. ឱ្យការផ្លាស់ប្ដូរជ្រើសរើសកម្រិតហានិភ័យរបស់វា
ហានិភ័យមកពីអ្វីដែលការផ្លាស់ប្ដូរប៉ះពាល់ មិនមែនមកពីអ្នកណា ឬអ្វីដែលបានសរសេរវានោះទេ។ ខ្ញុំនឹងប្រើបីកម្រិត៖
- ទាប៖ ឯកសារ អត្ថបទ និងការបកប្រែ។ ការពិនិត្យស្វ័យប្រវត្តិមួយ រួច merge នៅពេល CI ជាប់ (ពណ៌បៃតង)។
- មធ្យម៖ ការផ្លាស់ប្ដូរផលិតផលភាគច្រើន។ ការពិនិត្យស្វ័យប្រវត្តិដែលស៊ីជម្រៅជាងនេះ ហើយមនុស្សម្នាក់ពិនិត្យភស្តុតាង។
- ខ្ពស់៖ ការចូលប្រើ (sign-in) និងសិទ្ធិ, ការគណនាលុយ, ការផ្លាស់ប្ដូរ (migration) មូលដ្ឋានទិន្នន័យ, ការភ្ជាប់ជាមួយប្រព័ន្ធខាងក្រៅ និង script សម្រាប់ CI ឬការដាក់ឱ្យដំណើរការ (deploy)។ ការពិនិត្យស្វ័យប្រវត្តិដែលស៊ីជម្រៅបំផុត បូកនឹងការពិនិត្យសុវត្ថិភាព ហើយមនុស្សម្នាក់អាន diff។
កត់ត្រាផ្លូវ (path) ដែលមានហានិភ័យខ្ពស់ទុកជាលាយលក្ខណ៍អក្សរ ដើម្បីកុំឱ្យនរណាម្នាក់ជជែកវែកញែកអំពីវាម្ដងមួយករណីៗ។ ការយល់ព្រមរបស់ភ្នាក់ងារ AI មិនដែលរាប់ស្មើនឹងការយល់ព្រមរបស់មនុស្សទេ។ តាមឧត្តមគតិ គួរមានមនុស្សពីរនាក់អាន diff ដែលមានហានិភ័យខ្ពស់។ បើអ្នកមានតែម្នាក់ ការពិនិត្យស្វ័យប្រវត្តិបន្ថែម ជួសកន្លែងអ្នកទីពីរ។
- CI ឆ្លងកាត់
- ភស្តុតាងក្នុងការពិពណ៌នាថាវាដំណើរការ
- ការពិនិត្យដោយស្វ័យប្រវត្តិ ១ ជុំការពិនិត្យស្វ័យប្រវត្តិស៊ីជម្រៅជាង រហូតដល់ ២ ជុំការពិនិត្យស្វ័យប្រវត្តិស៊ីជម្រៅបំផុត រហូតដល់ ៣ ជុំ
- ការពិនិត្យសុវត្ថិភាព មិនត្រូវការ
- មិនត្រូវការមនុស្សទេ៖ វា merge ពេល CI ឆ្លងកាត់មនុស្សម្នាក់ពិនិត្យភស្តុតាងមនុស្សម្នាក់អាន diff
ការផ្លាស់ប្ដូរជ្រើសរើសកម្រិត ហើយកម្រិតជ្រើសរើសការត្រួតពិនិត្យ។
៥. កំណត់ចំនួនជុំនៃការពិនិត្យ
អ្នកពិនិត្យ AI តែងតែអាចរកឃើញរឿងមួយទៀត ហើយបើទុកឱ្យនៅតែឯង ភ្នាក់ងារ AI ដែលសរសេរ និងភ្នាក់ងារ AI ដែលពិនិត្យ នឹងធ្វើឱ្យគ្នាទៅវិញទៅមករវល់ពេញមួយយប់។ អ្វីដែលជុំក្រោយៗរកឃើញភាគច្រើន មាននៅតាំងពីជុំដំបូងរួចទៅហើយ។
ដូច្នេះ ចងចំនួនជុំទៅនឹងកម្រិត៖ មួយជុំសម្រាប់ទាប ពីរជុំសម្រាប់មធ្យម បីជុំសម្រាប់ខ្ពស់។ បន្ទាប់ពីជុំទីមួយ ពិនិត្យតែអ្វីដែលបានផ្លាស់ប្ដូរ។ ជួសជុលកំហុសនីមួយៗដែលត្រូវបានរកឃើញ នៅគ្រប់កន្លែងដែលវាលេចឡើង ហើយបង្កើត issue ដាច់ដោយឡែក សម្រាប់បញ្ហានៅក្នុងកូដដែលមិនបានប៉ះ។ បើជុំចុងក្រោយនៅតែរកឃើញបញ្ហា សូមគិតឡើងវិញអំពីវិធីសាស្ត្រ ជំនួសឱ្យការប៉ះប៉ូវម្ដងទៀត។
ក្រុម Claude Code បានបន្ថែមច្បាប់ស្រដៀងគ្នានេះ ហើយភាគរយនៃ pull request របស់ពួកគេដែលជាប់ក្រោយជុំតែមួយ បានកើនពី ៦៥ ទៅ ៧៨ ភាគរយ។
បើគ្មានការកំណត់ ភ្នាក់ងារ AI ពីរអាចធ្វើឱ្យគ្នារវល់ពេញមួយយប់។
៦. ឱ្យ script មួយចាប់កំហុសដែលគួរឱ្យធុញ
សង្កេតមើលអ្វីដែលជុំពិនិត្យដំបូងរបស់អ្នក រកឃើញម្ដងហើយម្ដងទៀត។ ជាញឹកញាប់ វាជារឿងមេកានិច៖ branch ដែលលែង merge បានស្អាត ការពិពណ៌នាដែលខ្វះកម្រិតហានិភ័យ ឬភស្តុតាង ឬ migration មូលដ្ឋានទិន្នន័យដែលត្រូវបានកែប្រែ ក្រោយពេលវាត្រូវបានដាក់ឱ្យប្រើរួចហើយ។ គ្មានអ្វីមួយក្នុងចំណោមនោះត្រូវការអ្នកពិនិត្យ AI ទេ ចុះទម្រាំតែមនុស្ស។
Script តូចមួយដែលពិនិត្យ branch និងការពិពណ៌នា មុនពេលការពិនិត្យចាប់ផ្ដើម អាចចាប់បានទាំងអស់នោះ។ បន្ទាប់ពីនោះ ជុំពិនិត្យនានាផ្ដោតលើ bug ពិតៗ។
៧. បំប្លែង bug ដែលរួចខ្លួនទៅជាច្បាប់
នៅពេល bug មួយរួចផុតពីការពិនិត្យ ការជួសជុលគួរតែបន្ថែមអ្វីដែលអាចចាប់វាបាន៖ តេស្តមួយ ច្បាប់ lint មួយ ឬបន្ទាត់មួយនៅក្នុងស្តង់ដារកូដដែលភ្នាក់ងារ AI អាន។ ដូចគ្នានេះដែរ នៅពេលអ្នកពិនិត្យរកឃើញកំហុសប្រភេទដដែលនៅលើ pull request ទីពីរ។ Pull request ដែលជួសជុលវា ត្រូវប្រាប់ថាវាបានបន្ថែមអ្វី។
ខ្ញុំក៏នឹងរក្សាបញ្ជីខ្លីមួយ នៃច្បាប់ដែលម៉ាស៊ីនពិនិត្យរួចហើយ ដើម្បីឱ្យអ្នកពិនិត្យទុកចិត្តលើការត្រួតពិនិត្យទាំងនោះ ហើយចំណាយពេលលើរឿងដែលត្រូវការការវិនិច្ឆ័យ។ ហើយច្បាប់មួយដែលខ្ញុំនឹងបន្ថែមតាំងពីថ្ងៃដំបូង៖ បើ ticket មួយនិយាយថា មុខងារណាមួយ «មានរួចហើយ» នោះ pull request ត្រូវមានតេស្តដែលបញ្ជាក់វា។ ភ្នាក់ងារ AI ពូកែណាស់ក្នុងការជឿថាកូដមាន ទោះបីវាមិនមានក៏ដោយ។
៨. រក្សាការរៀបចំឱ្យសាមញ្ញ
គេងាយនឹងចង់បង្កើត pipeline ដ៏ស្មុគស្មាញមួយ ដែលមានភ្នាក់ងារ AI មួយសម្រាប់រៀបផែនការ មួយសម្រាប់បង្កើត មួយសម្រាប់ពិនិត្យ មួយសម្រាប់តេស្ត និងមួយទៀតសម្រាប់វាយតម្លៃតេស្ត។ ខ្ញុំបានបង្កើតមួយនៅខែនេះ ហើយបោះចោលវាពីរសប្ដាហ៍ក្រោយមក។ Session ភ្នាក់ងារ AI តែមួយដែលធ្វើការងារទាំងមូល ជាមួយការពិនិត្យក្នុង context ថ្មីនៅចុងបញ្ចប់ បានធ្វើការងារដូចគ្នា ដោយមានផ្នែកដែលត្រូវថែទាំតិចជាងច្រើន។
Anthropic បានឈានដល់ការសន្និដ្ឋានស្រដៀងគ្នា នៅក្នុង ពេលណាគួរបញ្ចូល subagent ទៅក្នុងរង្វិលជុំមេរបស់ភ្នាក់ងារ AI។ កន្លែងតែមួយគត់ដែលខ្ញុំនឹងនៅតែប្រើភ្នាក់ងារ AI ដាច់ដោយឡែក គឺការពិនិត្យ ព្រោះអ្នកពិនិត្យដែលមិនបានសរសេរកូដ មិនមានការសន្មតដូចអ្នកសរសេរទេ។
៩. ធ្វើឱ្យការកែកំហុសវិញ ងាយស្រួល និងថោក
ការពិនិត្យនឹងមើលរំលងរឿងខ្លះ។ ដូច្នេះ ធ្វើឱ្យងាយស្រួល និងលឿនក្នុងការបិទការភ្ជាប់ ឬមុខងារដែលមានហានិភ័យ ដោយមិនចាំបាច់ deploy រក្សា pull request ឱ្យតូចល្មមនឹង revert បានស្អាត ហើយប្រាប់ក្នុងការពិពណ៌នាពីរបៀបលុបវាវិញ។
អ្វីដែលមនុស្សនៅតែធ្វើ
មនុស្សជាអ្នកសម្រេចថា តើត្រូវបង្កើតអ្វីតាំងពីដំបូង។ មនុស្សអាន diff ដែលមានហានិភ័យខ្ពស់ ពិនិត្យភស្តុតាងសម្រាប់អ្វីៗផ្សេងទៀត ហើយទទួលខុសត្រូវលើអ្វីដែលដាក់ឱ្យប្រើ មិនថាអ្នកណាជាអ្នកវាយវានោះទេ។
ហើយមនុស្សជាអ្នករក្សាតួលេខដែលប្រាប់អ្នកថា តើអ្វីៗទាំងអស់នេះដំណើរការឬអត់។ បើខ្ញុំចាប់ផ្ដើមនៅថ្ងៃនេះ តួលេខដំបូងដែលខ្ញុំនឹងតាមដាន គឺភាពញឹកញាប់ដែលការផ្លាស់ប្ដូរដែលបាន merge ត្រូវ revert។ បើវាកើនឡើង អ្នកមិនបានសន្សំពេលវេលាទេ អ្នកគ្រាន់តែផ្លាស់វាទៅកន្លែងផ្សេង។
បើ AI ក៏សរសេរកូដរបស់អ្នកភាគច្រើនដែរ តើអ្នកសម្រេចដោយរបៀបណាថា ការផ្លាស់ប្ដូរណាខ្លះនៅតែត្រូវការមនុស្សអាន?
0ចូលចិត្ត
អរគុណ!អត្ថបទនេះបានចុះផ្សាយដំបូងនៅលើ linkedin.com